利用 transformer 进行动态病毒检测

前言 思路以及数据集一览 上篇文章提到了使用调用 api 的顺序来当作病毒的特征,也就是说把一个病毒的 api 调用顺序当成它说话说的单词,根据它说的句子来判断它是哪种人。有关这种 api 调用的数据集有很多,其中看到了一篇论文,他的数据集相当直观。该论文使用的是 LSTM 模型。LSTM 模型对处理这种序列顺序十分友好。我仔细看了看数据的 api 调用链序列,发现其实不算短,最长的可以用离谱来
前言
思路以及数据集一览
上篇文章提到了使用调用 api 的顺序来当作病毒的特征,也就是说把一个病毒的 api 调用顺序当成它说话说的单词,根据它说的句子来判断它是哪种人。有关这种 api 调用的数据集有很多,其中看到了一篇论文,他的数据集相当直观。该论文使用的是 LSTM 模型。LSTM 模型对处理这种序列顺序十分友好。我仔细看了看数据的 api 调用链序列,发现其实不算短,最长的可以用离谱来形容。所以理论上 transformer 也能跑出不错的效果。但是过程比想象中的艰辛,甚至可以说是一步一个坎,起个副标题可以叫:更适合垃圾电脑宝宝体质的 transformer 之如何调出一个更适合自己数据集的模型。
论文数据集的 api 调用是把 github 上爬下来的恶意软件放到 Cuckoo 沙箱里得出来的,之后产生的数据放入了 mongodb 中,其类别是用 VirusTotal 获取的。其数据具体格式如下:

上图是论文给的一个小例子,一行一个病毒的 api 调用链
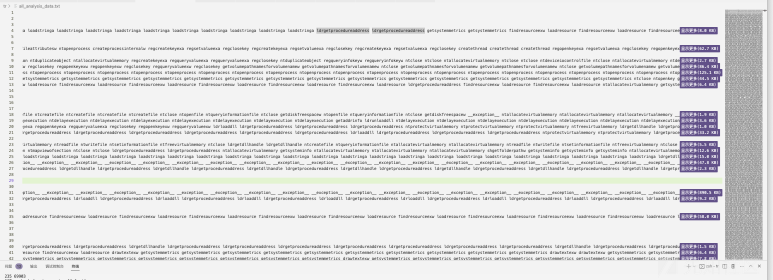
完整的数据长上图这个样子,我把数据横向拖到最后,给大家看看一行长的数据能有多长:

然后标签文件的话就是,标签和行号相互对应,一共八个类别。
预处理
最花时间的一步
踩的坑
说是最花时间,其实也就是生成数据很麻烦。整体看下来还是很简单的。
首先我用箱型图简单处理了一下。发现他的长度范围是真的挺离谱,最长的一行竟然有 1764421 个调用。我一开始想法很简单,就天真的想把不足 1764421 直接补成 None 就好了(transformer进行处理前要进行数据补齐,让输入维度相等才能继续进行),也就是说把所有的 api 转化成数字之后直接生成一个数字序列(下节具体介绍),然后不足这个最长的直接补成 0/-1

然后就用这个想法把 dataset 给写完了,没错,我就是在加载数据集的时候直接强行补0,朴实无华

我发现每次都直接给我杀了,我不信邪,又在 windows 上跑了一遍,还是不行

于是又想了个方法,用下rnn库里边的pad_sequence。结果还是直接被杀死,我就又去 windows 平台跑了一下,它提供了个报错,说我内存不够,需要开辟100g。那我直接重新生成个数据集,跑出一个padded过的数据集。
然后这里省略 100 字,就是真的不行,不能直接读到内存里,然后一起放,而是需要一行一行的补齐。最后跑出来又是花了好久,跑完我简单看了眼文件大小,好家伙二十多个g,用head看一下前10行都要在终端滚好久。

于是果断放弃,直接用分割子序列的方式。这里学到了许多(这也算第一次接触transformer,之前用的都是Vit,根本不需要考虑这种不定长的问题)
索引化并拆分
首先很自然的一步就是把 api 中的单词(函数名)转成数字。逻辑见代码,维护一个字典,不在字典里就注册一个,在的话就改成继续执行,遍历完后往里写:
# 读取数据文件
with open('all_analysis_data.txt', 'r') as f:
    data = f.readlines()
# 将单词转换为独一无二的数字
word_to_id = {}
id_to_word = {}
id = 0
for line in data:
    words = line.strip().split()
    for word in words:
        if word not in word_to_id:
            word_to_id[word] = id
            id_to_word[id] = word
            id += 1
# 输出单词和对应的数字
for word, id in word_to_id.items():
    print(f'{word}: {id}')
# ...从零开始的
# getusernameexa: 269
# netusergetlocalgroups: 270
# findwindowexw: 271
# deleteurlcacheentryw: 272
# rtlcreateuserthread: 273
# setinformationjobobject: 274
# cryptprotectmemory: 275
# cryptunprotectmemory: 276
# findfirstfileexa: 277
# 将数据转换为数字序列
data_ids = []
for line in data:
    words = line.strip().split()
    ids = [word_to_id[word] for word in words]
    data_ids.append(ids)


# 将数字序列保存到文件中
with open('data_ids.txt', 'w') as f:
    for ids in data_ids:
        f.write(' '.join(str(id) for id in ids))
        f.write('\n')
之后得到的data_ids.txt就简单很多了

然后数据预处理函数就手拿把馅儿了,需要特别注意的是划分子序列,到底应该采用什么方式?
事实上从刚才的箱形图可以看到,病毒的 api 调用链范围拉的很长,如何挑选最为合适?这需要根据真正的场景去思考设为多少更合适。我看了几篇讲病毒 api 调用个数的,有几个甚至强调了病毒调用次数和是不是病毒有很大关系。我尝试把中位数打出来,发现长度 633 是中位数。需要注意的是把 633 当成一个 seq 最大长度会导致网络训练特别慢,我尝试了下400、300、200、100,拿了点训练数据测试了下,发现区别很明显,一个 epoch 过后,400训练出来差不多是40%,300 和 200 训练一次出来差不多是 60%。但我拿 100 又试了试,发现 100 效果最好(79%),于是就先用 100 试试
此外设不设重叠区域我也纠结了下,即比如一个调用链是这样:2 3 1 29 11 12 23,然后我切分的时候假如最大长度是3,我需要把它划分为2 3 1|29 11 12|23 0 0,但此时我的重叠区域设置为 1 的话他的调用链就会让头尾有重叠的部分:2 3 1|1 29 11|11 12 23。我纠结了一下,最后选择不设置了,原因就是有没有重叠其实对于 api 而言没有 nlp 中单词之间联系那么紧密,当然肯定是有的。比如对于语句来说,一个句子中最一开始的单词也有可能对句子末尾的单词产生巨大影响, api 调用肯定也会存在出现巨大影响的情况,但不会有 nlp 那么频繁。此外因为需要计算多次还会增加计算量还可能导致模型过拟合。两种形式都在下方代码中:
# 定义数据预处理函数
def preprocess_data(data_file, label_file, max_seq_len):
    # 读取数据文件和标签文件
    with open(data_file, 'r') as f:
        data = f.readlines()
    with open(label_file, 'r') as f:
        labels = f.readlines()
    # 将数据和标签转换为数字序列
    data = [[int(x) for x in row.strip().split()] for row in data]
    labels = [int(x) for x in labels]
    # 将数据分成子序列并补0
    sub_data = []
    sub_labels = []
    for i in range(len(data)):
        row = data[i]
        label = labels[i]
        for j in range(0, len(row), max_seq_len):
        #for j in range(0, len(row)-max_seq_len+1, max_seq_len//2):#步长短点就行
            sub_row = row[j:j+max_seq_len] + [278]*(max_seq_len-len(row[j:j+max_seq_len]))#不能是0,因为0也是个函数
            sub_data.append(sub_row)
            sub_labels.append(label)
    # 将标签转换为one-hot编码
    sub_labels = [torch.eye(8)[label] for label in sub_labels]
    # 返回数据和标签
    return sub_data, sub_labels
整体代码
Transformer 参数详细解释
class TransformerModel(nn.Module):
    def __init__(self, input_size, output_size, max_seq_len, num_layers=3, hidden_size=128, num_heads=8, dropout=0.1):
        super(TransformerModel, self).__init__()
        self.embedding = nn.Embedding(input_size, hidden_size)
        self.positional_encoding = nn.Parameter(torch.zeros(max_seq_len, hidden_size))
        self.encoder_layers = nn.TransformerEncoderLayer(hidden_size, num_heads, hidden_size*4, dropout)
        self.encoder = nn.TransformerEncoder(self.encoder_layers, num_layers=num_layers)
        self.fc = nn.Linear(hidden_size, output_size)
    def forward(self, x):
        x = self.embedding(x) + self.positional_encoding[:x.size(1), :]
        x = self.encoder(x.transpose(0, 1)).transpose(0, 1)
        x = self.fc(x[:, -1, :])
        return x
可以看到为了性能做了很多取舍,尤其是隐藏层的大小,我直接打了个 1 折。大家可以调着玩玩,性能好的话可以往上堆着试试
下面是对这些参数的详细解释:
input_size:输入序列的词汇表大小。它表示输入序列中可能出现的不同单词的数量,在本文里,就是最后索引出来的最大值,当然因为我们有个补齐的操作,最后还要加一output_size:输出序列的大小。它表示模型输出的向量的维度,这个也是定死的,因为类别固定max_seq_len:输入序列的最大长度。它表示输入序列中最多包含的单词数量,这里边超参数我设置的是100num_layers:Transformer模型中的编码器层数。表示模型中编码器的数量hidden_size:Transformer模型中的隐藏层大小。它表示模型中隐藏层的向量维度,这里边默认应该是 1024,我直接减到了 128num_heads:Transformer模型中的多头注意力头数。它表示模型中每个注意力层中的注意力头数量,也可以说是把注意力映射到了多少个维度中
完整版
# 导入必要的库
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import Dataset, DataLoader

# 定义数据预处理函数
def preprocess_data(data_file, label_file, max_seq_len):
    # 读取数据文件和标签文件
    with open(data_file, 'r') as f:
        data = f.readlines()
    with open(label_file, 'r') as f:
        labels = f.readlines()
    # 将数据和标签转换为数字序列
    data = [[int(x) for x in row.strip().split()] for row in data]
    labels = [int(x) for x in labels]
    # 将数据分成子序列并补齐
    sub_data = []
    sub_labels = []
    for i in range(len(data)):
        row = data[i]
        label = labels[i]
        for j in range(0, len(row), max_seq_len):
            sub_row = row[j:j+max_seq_len] + [278]*(max_seq_len-len(row[j:j+max_seq_len]))
            sub_data.append(sub_row)
            sub_labels.append(label)
    # 将标签转换为one-hot编码
    sub_labels = [torch.eye(8)[label] for label in sub_labels]
    # 返回数据和标签
    return sub_data, sub_labels

# 定义数据集类
class MyDataset(Dataset):
    def __init__(self, data, labels):
        self.data = data
        self.labels = labels
    def __len__(self):
        return len(self.data)
    def __getitem__(self, idx):
        return torch.tensor(self.data[idx]), self.labels[idx]
    # 定义Transformer模型类
class TransformerModel(nn.Module):
    def __init__(self, input_size, output_size, max_seq_len, num_layers=3, hidden_size=128, num_heads=8, dropout=0.1):
        super(TransformerModel, self).__init__()
        self.embedding = nn.Embedding(input_size, hidden_size)
        self.positional_encoding = nn.Parameter(torch.zeros(max_seq_len, hidden_size))
        self.encoder_layers = nn.TransformerEncoderLayer(hidden_size, num_heads, hidden_size*4, dropout)
        self.encoder = nn.TransformerEncoder(self.encoder_layers, num_layers=num_layers)
        self.fc = nn.Linear(hidden_size, output_size)
    def forward(self, x):
        x = self.embedding(x) + self.positional_encoding[:x.size(1), :]
        x = self.encoder(x.transpose(0, 1)).transpose(0, 1)
        x = self.fc(x[:, -1, :])
        return x


# 定义训练函数
def train(model, train_loader, optimizer, criterion):
    model.train()
    train_loss = 0
    i=0
    for data, labels in train_loader:
        data=data.cuda()
        labels=labels.cuda()
        print(i,len(train_loader))
        i+=1
        optimizer.zero_grad()
        outputs = model(data)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * data.size(0)
    train_loss /= len(train_loader.dataset)
    torch.save(model.state_dict(), f'model.pth')
    return train_loss

# 定义测试函数
def test(model, test_loader, criterion):
    model.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, labels in test_loader:
            data=data.cuda()
            labels=labels.cuda()
            outputs = model(data)
            test_loss += criterion(outputs, labels).item() * data.size(0)
            pred = outputs.argmax(dim=1, keepdim=True)
            correct += pred.eq(labels.argmax(dim=1, keepdim=True)).sum().item()
    test_loss /= len(test_loader.dataset)
    accuracy = correct / len(test_loader.dataset)
    return test_loss, accuracy

# 加载数据并进行预处理
data_file = "data_ids.txt"
label_file = "label_ids.txt"
max_seq_len = 100
data, labels = preprocess_data(data_file, label_file, max_seq_len)

# 划分训练集和测试集
train_size = int(0.8 * len(data))
test_size = len(data) - train_size
train_data, test_data = data[:train_size], data[train_size:]
train_labels, test_labels = labels[:train_size], labels[train_size:]

# 创建数据集和数据加载器
train_dataset = MyDataset(train_data, train_labels)
test_dataset = MyDataset(test_data, test_labels)
batch_size = 32
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)

# 创建模型并定义优化器和损失函数
input_size = 300
output_size = 8
model = TransformerModel(input_size, output_size, max_seq_len).cuda()
optimizer = optim.Adam(model.parameters(), lr=0.001)
criterion = nn.BCEWithLogitsLoss()

# 训练模型并测试
num_epochs = 10
for epoch in range(num_epochs):
    print(epoch)
    train_loss = train(model, train_loader, optimizer, criterion)
    test_loss, accuracy = test(model, test_loader, criterion)
    print("Epoch [{}/{}], Train Loss: {:.4f}, Test Loss: {:.4f}, Accuracy: {:.2f}%".format(epoch+1, num_epochs, train_loss, test_loss, accuracy*100))