gpt4free源码分析

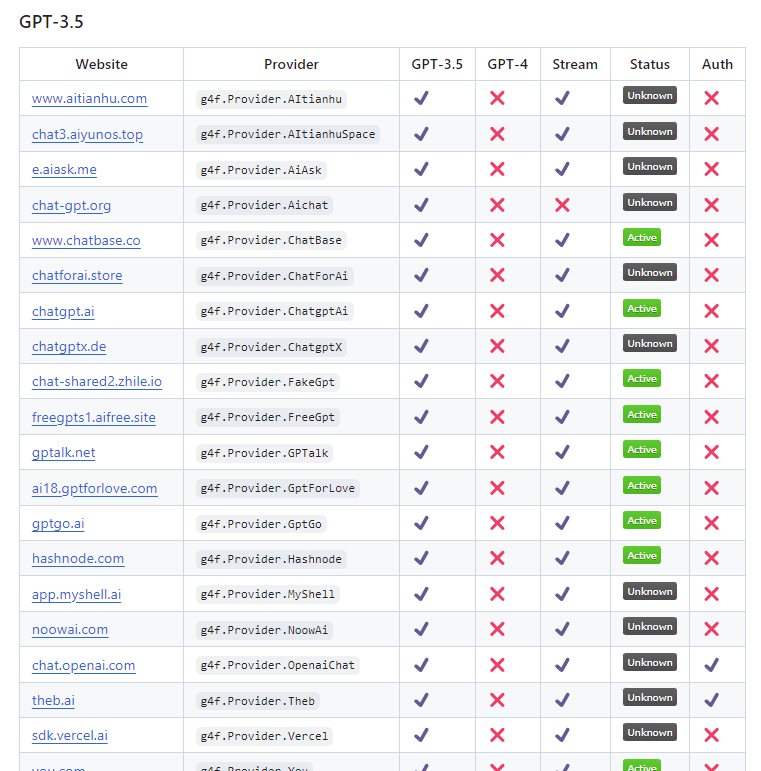
简介 项目地址 https://github.com/xtekky/gpt4free 该项目能够让用户免费试用GPT,具体的实现是针对公网GPT存在的各种安全问题进行了认证的绕过 截止写这篇文章的时候 gpt4free使用的GPT3.5的接口有 另外还有一个很多用户自行搭建的GPT站点 对应的源码是 https://github.com/Chanzhaoyu/chatgpt-web 但是老版
简介
项目地址 https://github.com/xtekky/gpt4free
该项目能够让用户免费试用GPT,具体的实现是针对公网GPT存在的各种安全问题进行了认证的绕过
截止写这篇文章的时候 gpt4free使用的GPT3.5的接口有
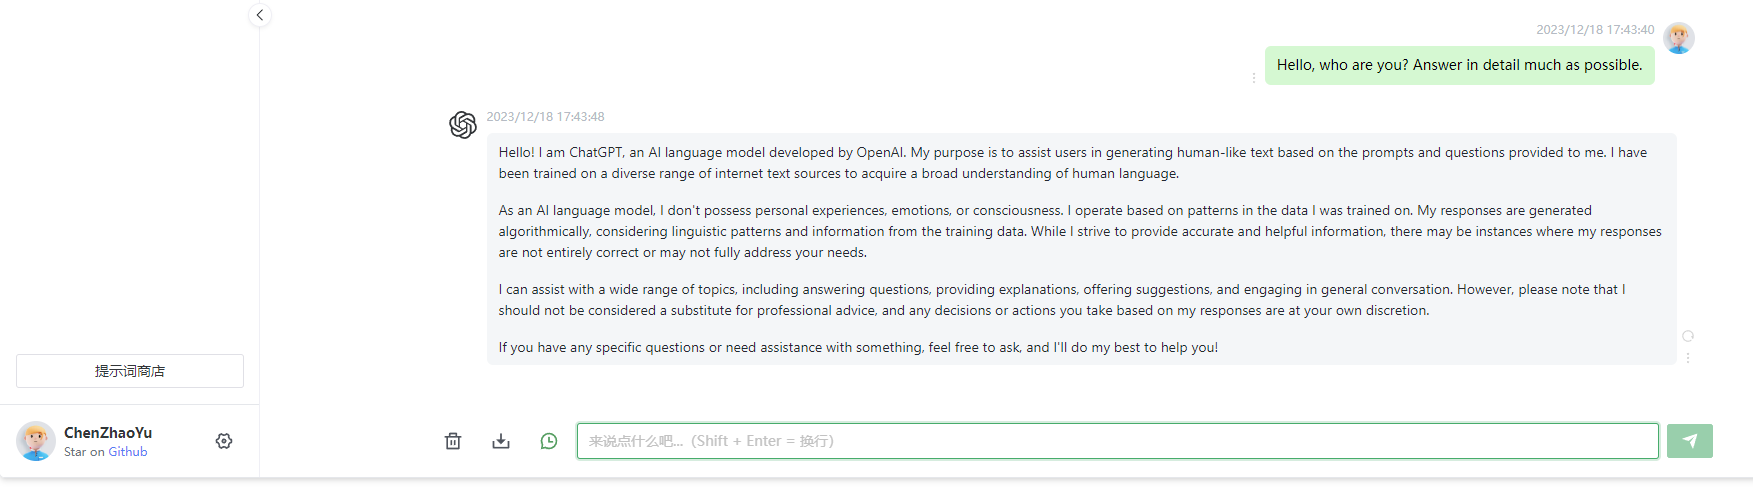
另外还有一个很多用户自行搭建的GPT站点 对应的源码是 https://github.com/Chanzhaoyu/chatgpt-web
但是老版本存在未授权访问的问题,可以通过未授权直接使用,使用FOFA搜索
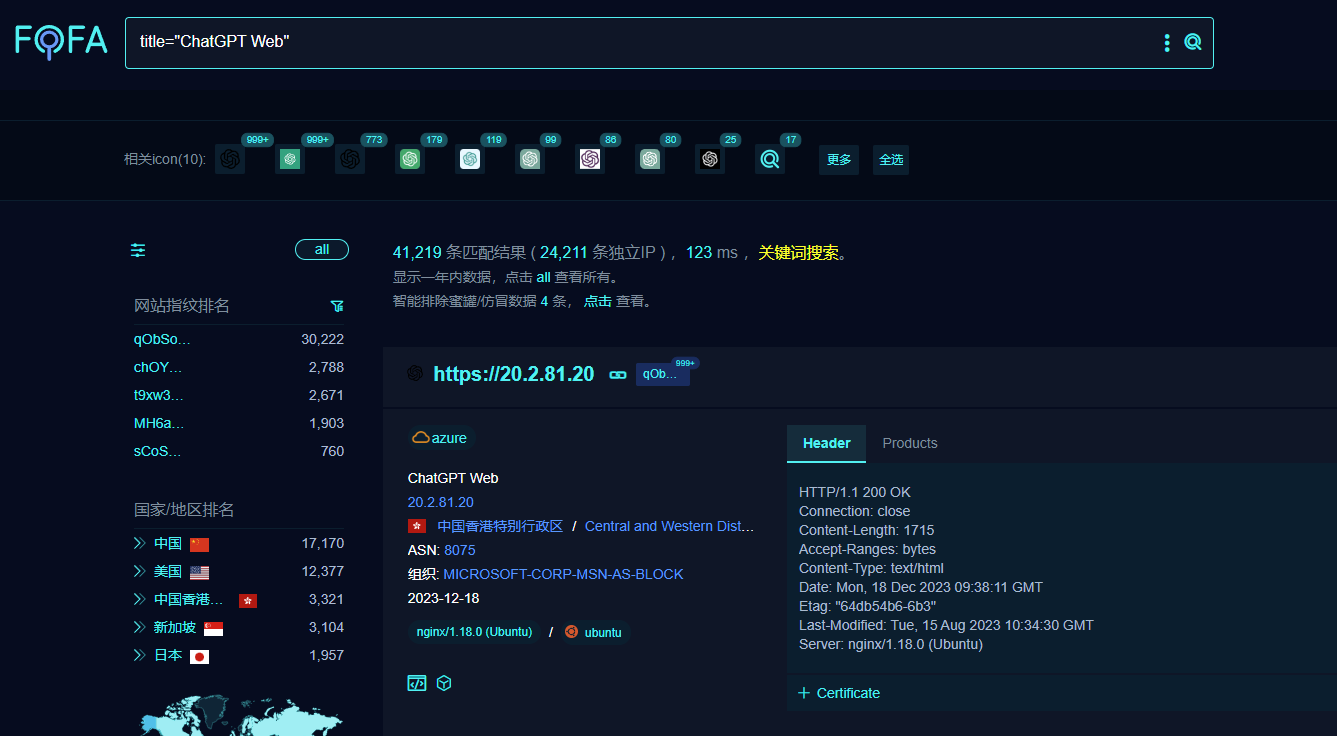
多尝试几个就可以找到可用的
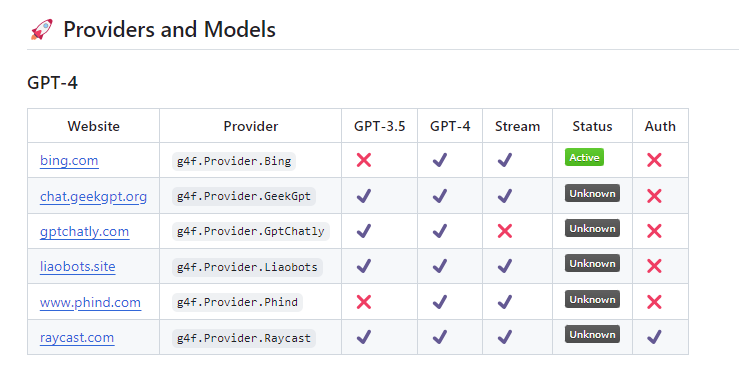
gpt4free使用的GPT4的接口有
安装运行
运行web版本的
python .\g4f\gui\run.py
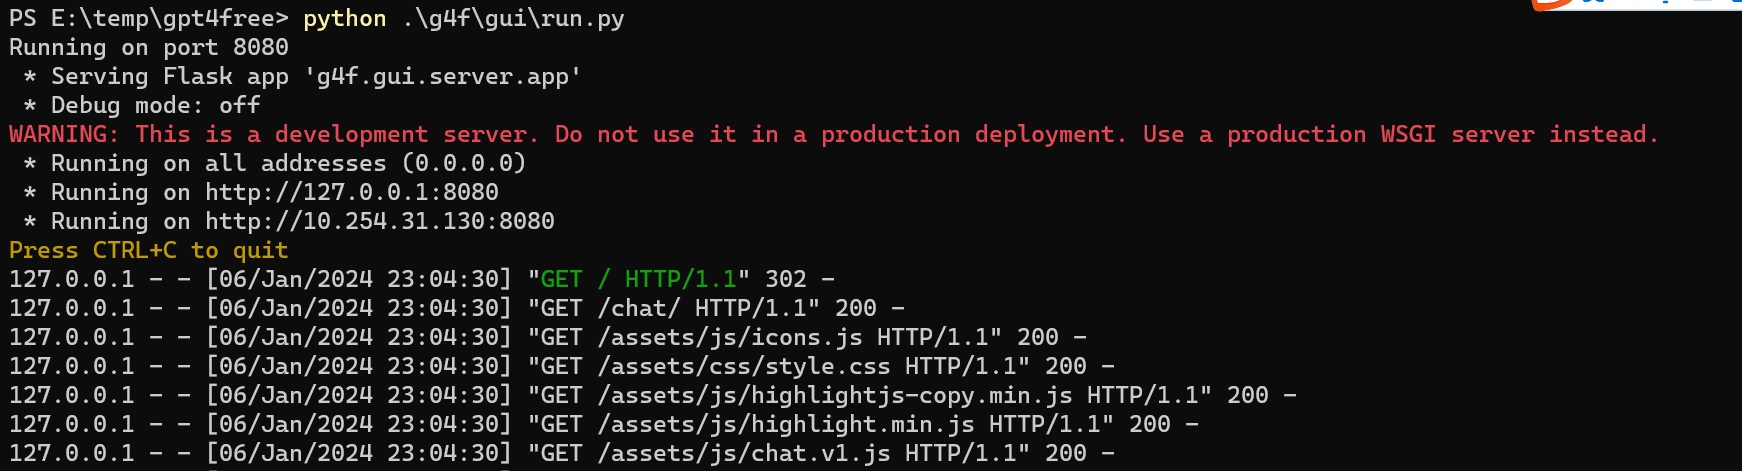
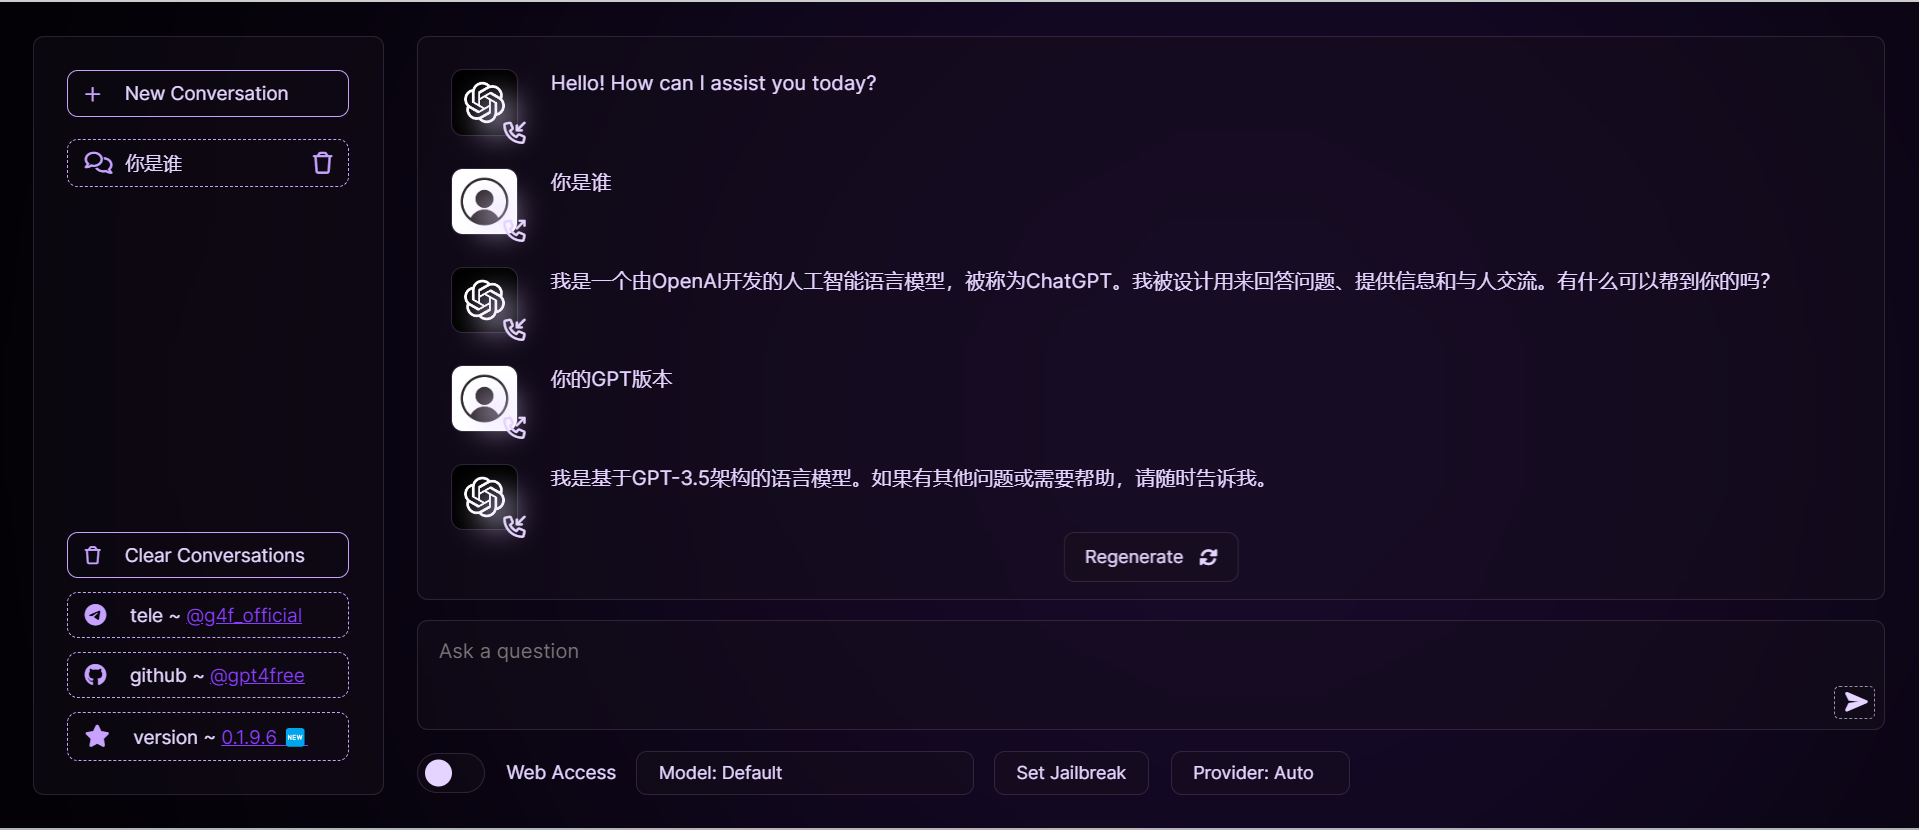
默认的模型是3.5
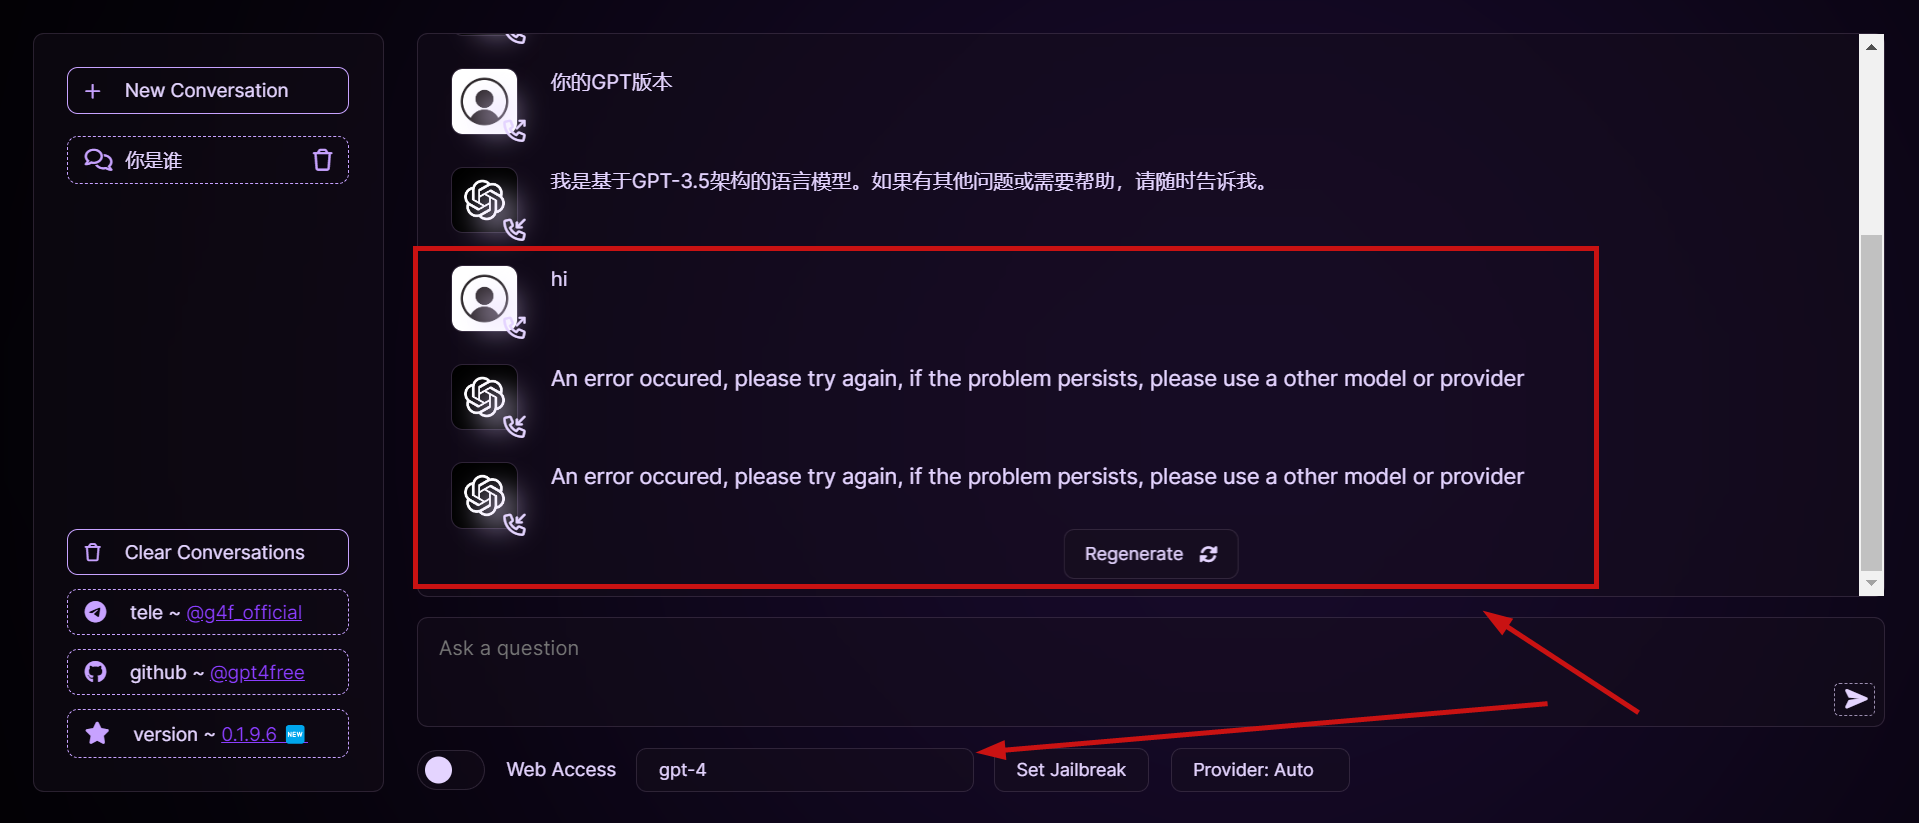
切换到gpt4之后就不行了
也可以使用python包的方式
import g4f

g4f.debug.logging = False  # Enable debug logging
g4f.debug.check_version = False  # Disable automatic version checking
# print(g4f.Provider.Bing.params)  # Print supported args for Bing

# Using automatic a provider for the given model
## Streamed completion
response = g4f.ChatCompletion.create(
    model="gpt-3.5-turbo",
    messages=[{"role": "user", "content": "昨天的当天是明天的什么"}],
    stream=True,
)
for message in response:
    print(message, flush=True, end='')
输出答案为(实际测试的时候这部分输出等待的时间挺长的)
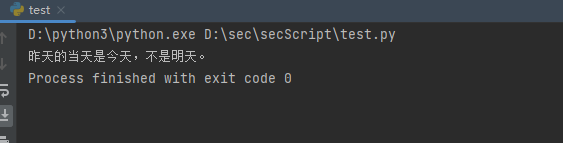
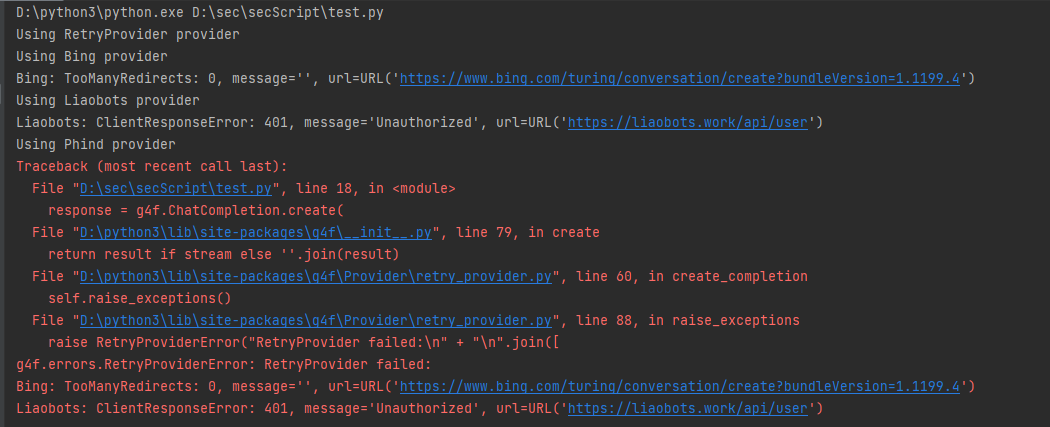
如果使用GPT4的API
import g4f

g4f.debug.logging = True  # Enable debug logging
g4f.debug.check_version = False  # Disable automatic version checking

## Normal response
response = g4f.ChatCompletion.create(
    model=g4f.models.gpt_4,
    messages=[{"role": "user", "content": "昨天的当天是明天的什么"}],
)  # Alternative model setting

print(response)
在国内IP的情况下 运行结果如下
运行流程
从web入口run.py跟进查看
def run_gui_args(args):
    host = args.host
    port = args.port
    debug = args.debug
    run_gui(host, port, debug)
web后端是使用的flask框架,对话的API接口是 /backend-api/v2/conversation
前端收到了用户的输入之后传递给对应接口
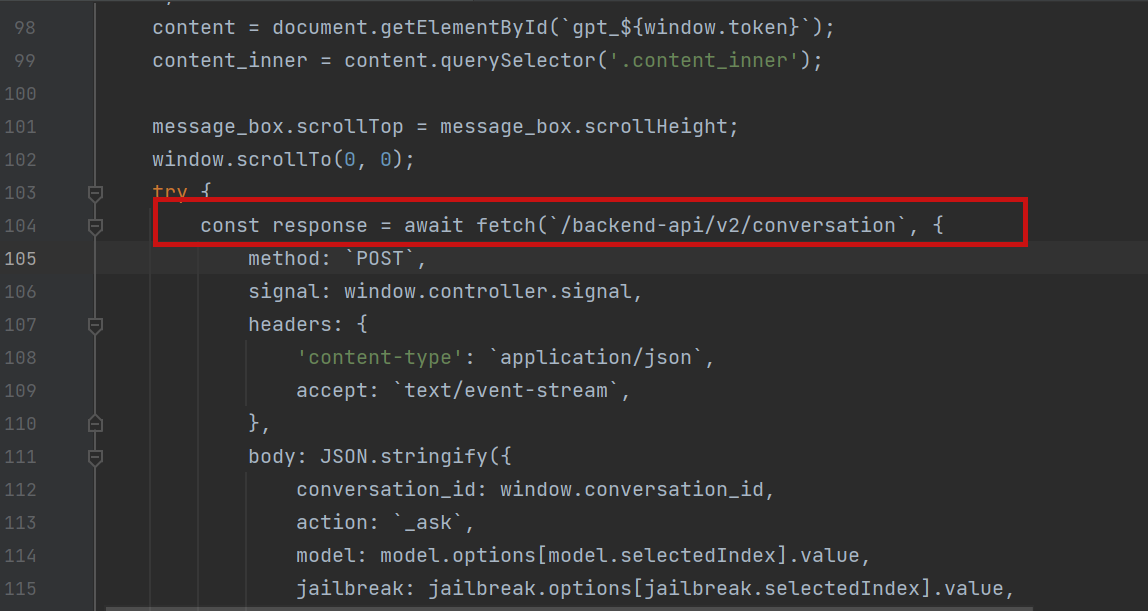
后台python解析参数并且传递给选择的模型,最后返回结果
def _conversation(self):
    ......
    messages = request.json['meta']['content']['parts']
    model = model if model else g4f.models.default
    ......
    for chunk in g4f.ChatCompletion.create(
        model=model,
        provider=provider,
        messages=messages,
        stream=True,
        ignore_stream_and_auth=True
    ):
        yield ......
默认的模型跟进查看
default = Model(
    name          = "",
    base_provider = "",
    best_provider = RetryProvider([
        Bing,
        ChatgptAi, GptGo, GeekGpt,
        You,
        Chatgpt4Online
    ])
)
这也是相对来说比较稳定的,我们就从这些模型里面学习是如何《偷走》GPT资源的
机制绕过
在Provider文件夹下面可以看到所有的模型,下面的部分网址需要使用魔法
Bing
使用谷歌浏览器访问 https://bing.com/chat , 进入聊天界面
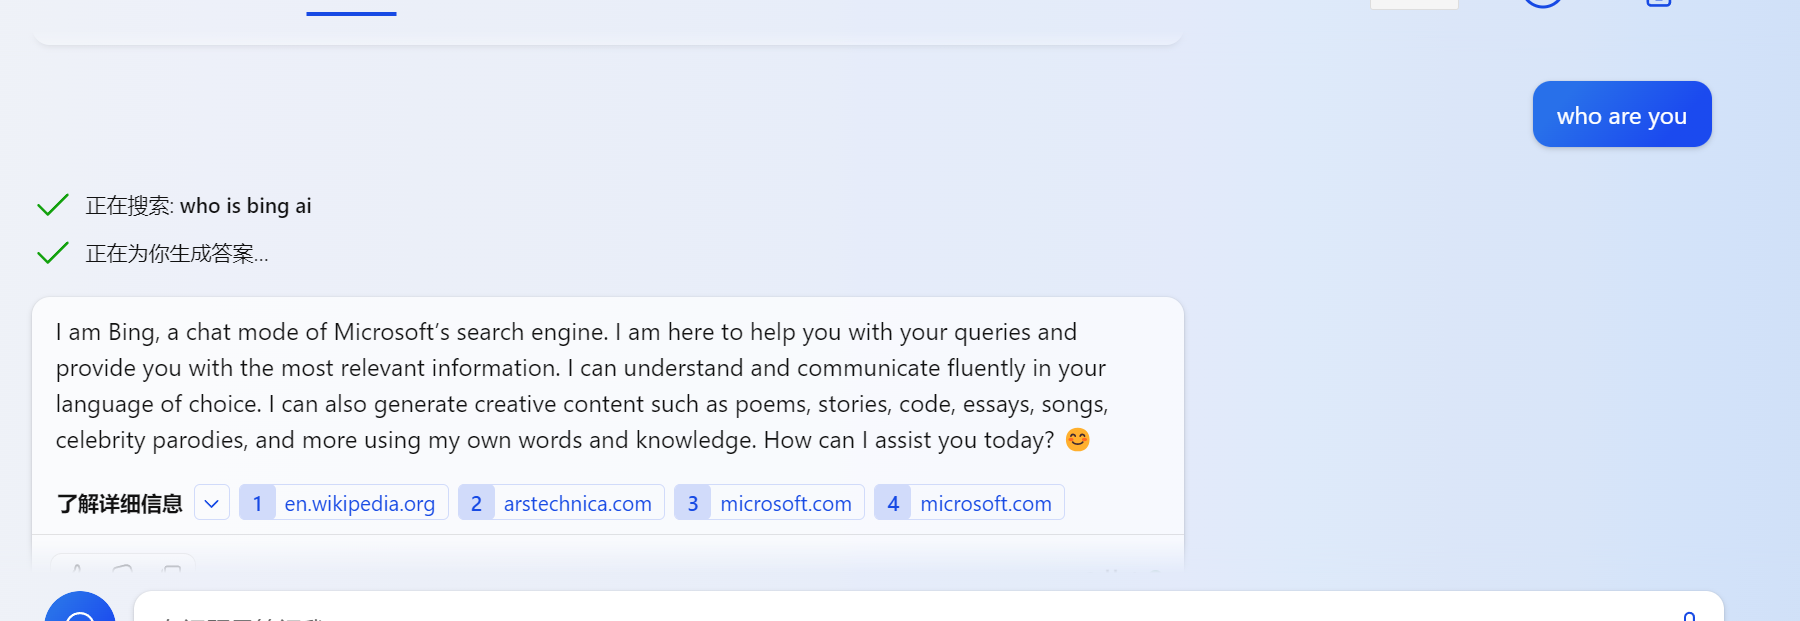
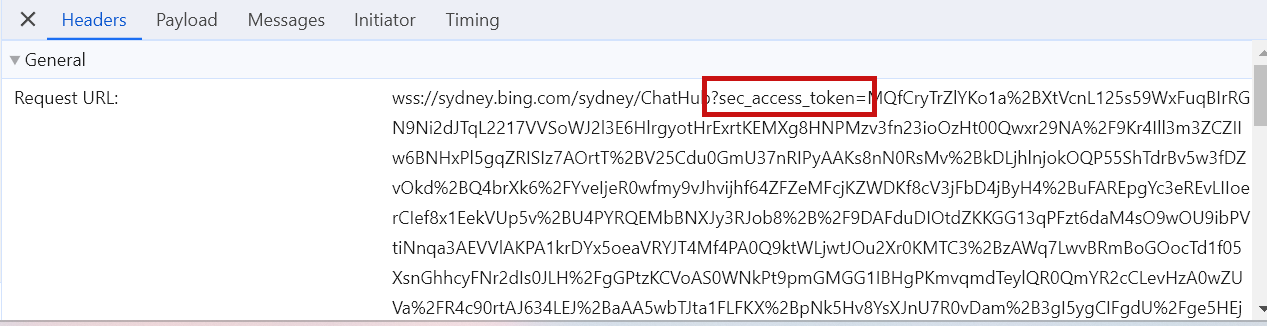
测试之后可以发现最后返回的数据接口是 wss://sydney.bing.com/sydney/ChatHub
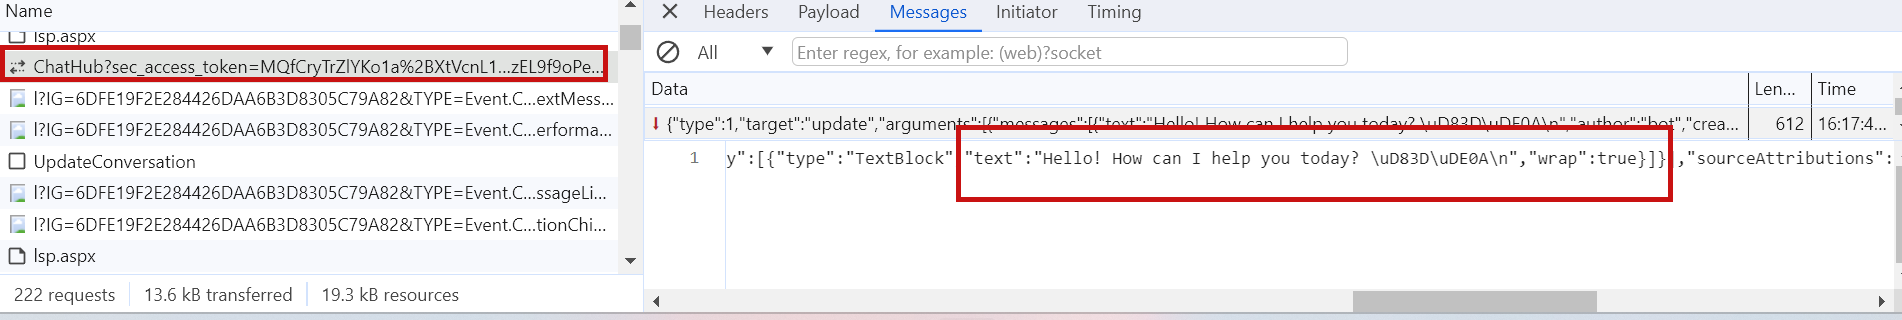
需要带上一个 sec_access_token
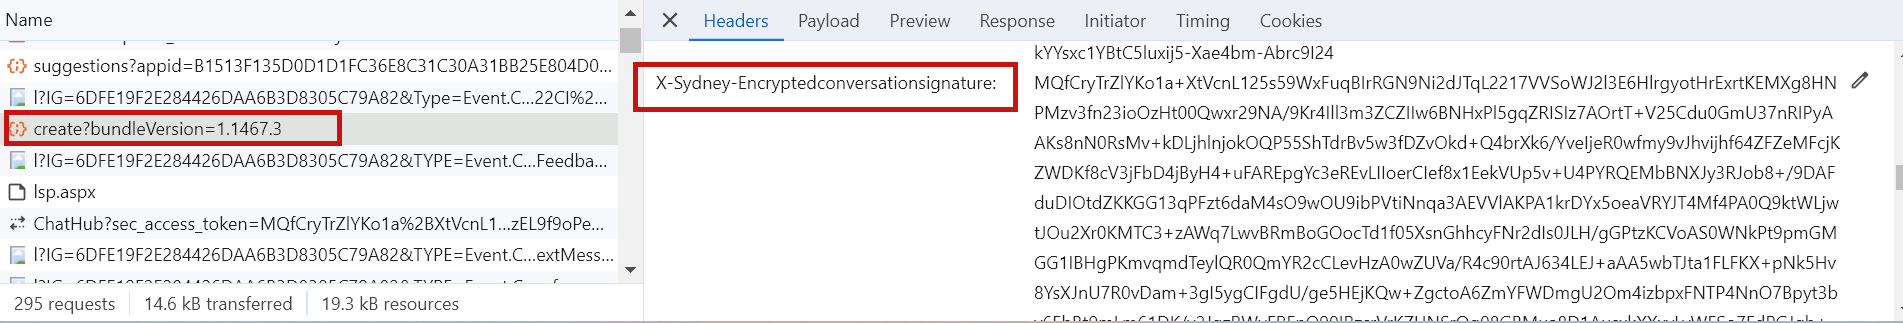
而sec_access_token又在访问/turing/conversation/create?bundleVersion=时会返回在响应头里面作为X-Sydney-Encryptedconversationsignature
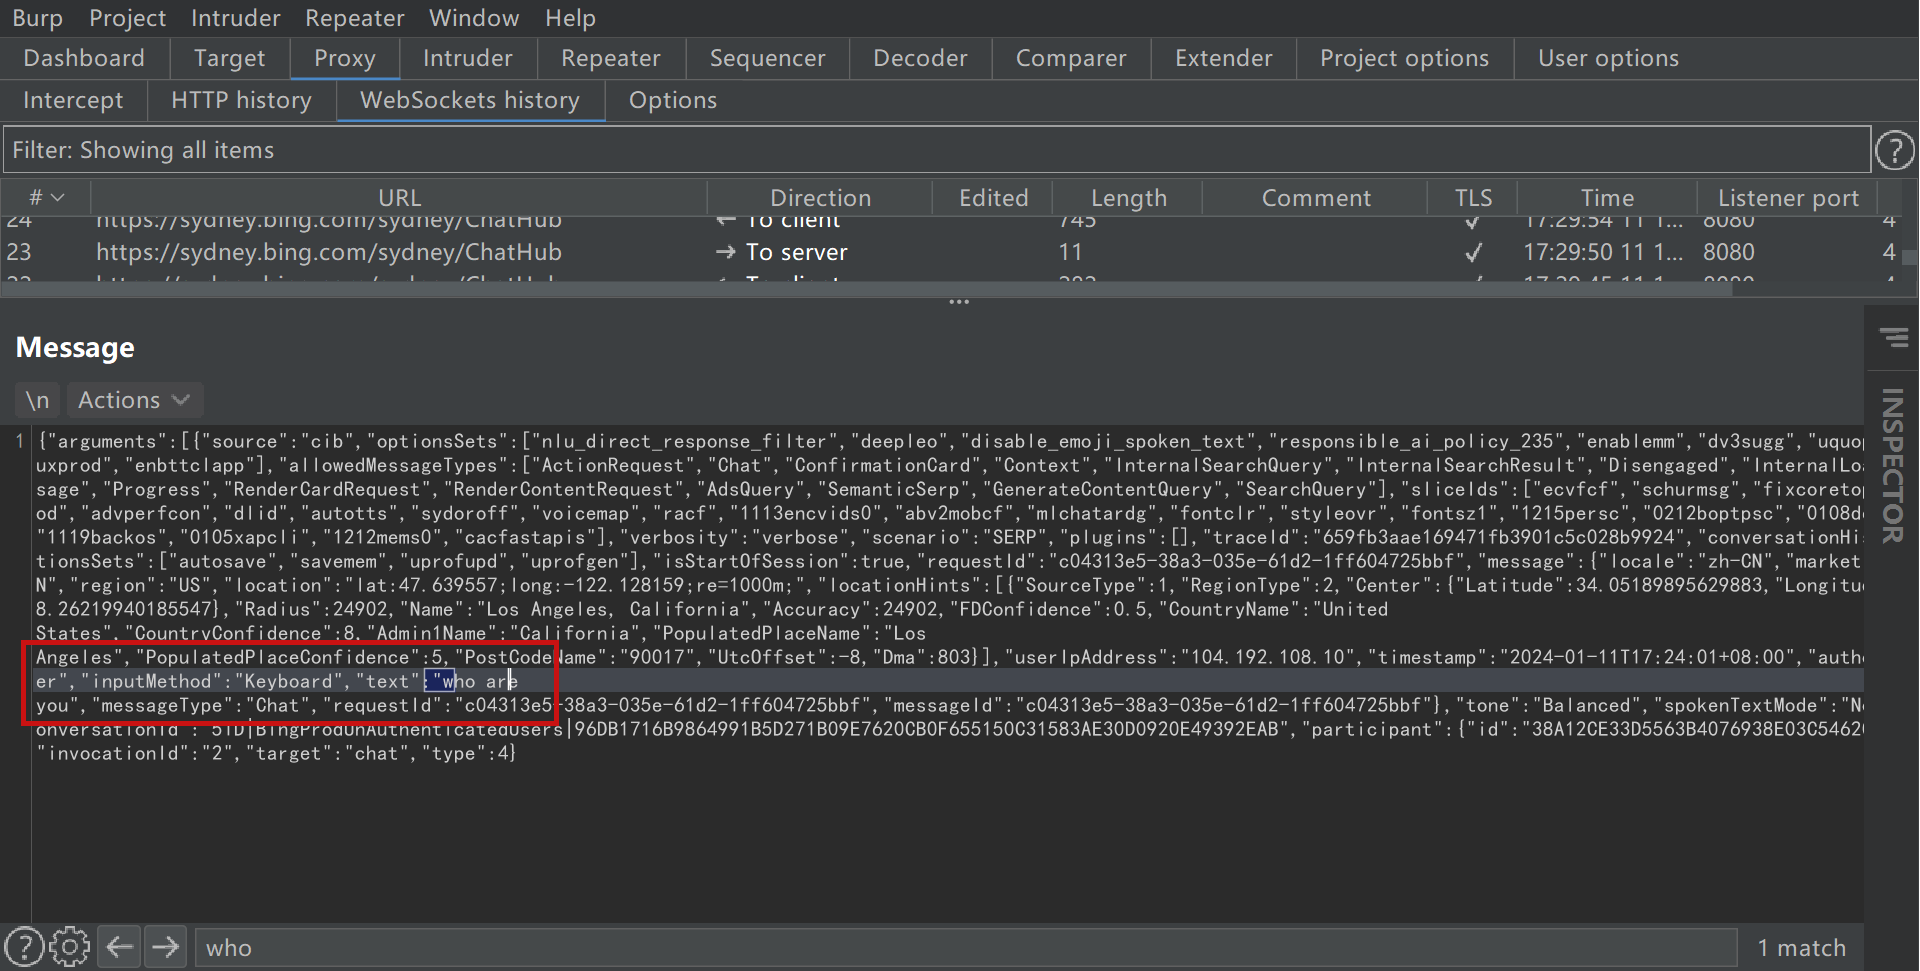
但是好像没有提到我们怎么把prompt传过去的,因为这个是websocket建立链接后进行的,直接在F12里面看不到
使用burpsuite查看websockets history,这个是我们发过去的数据
回复的响应为
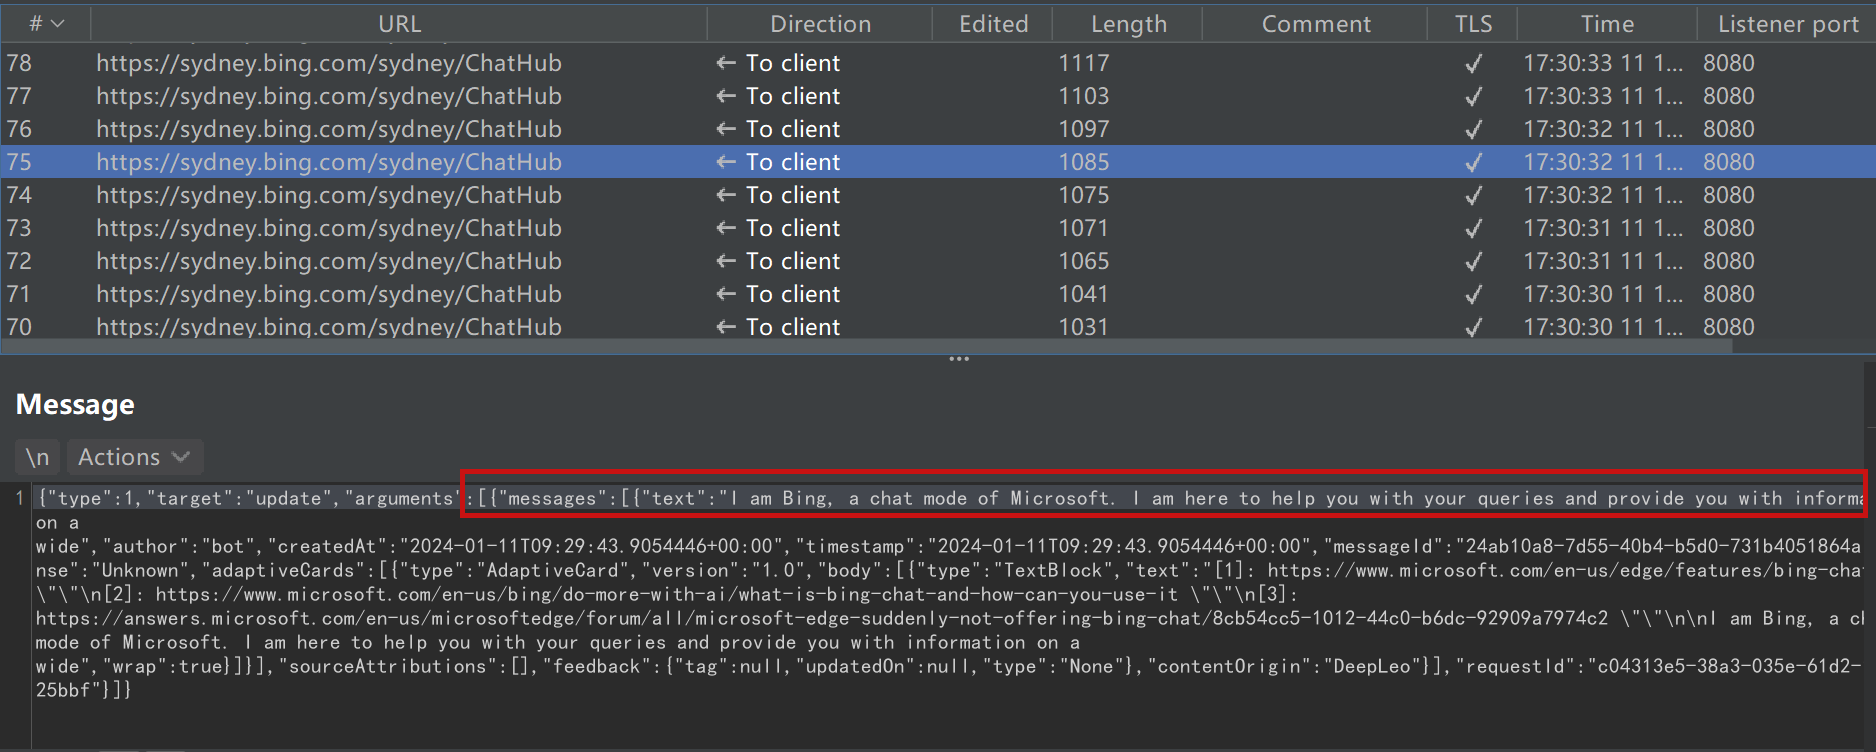
可以看到是一致的
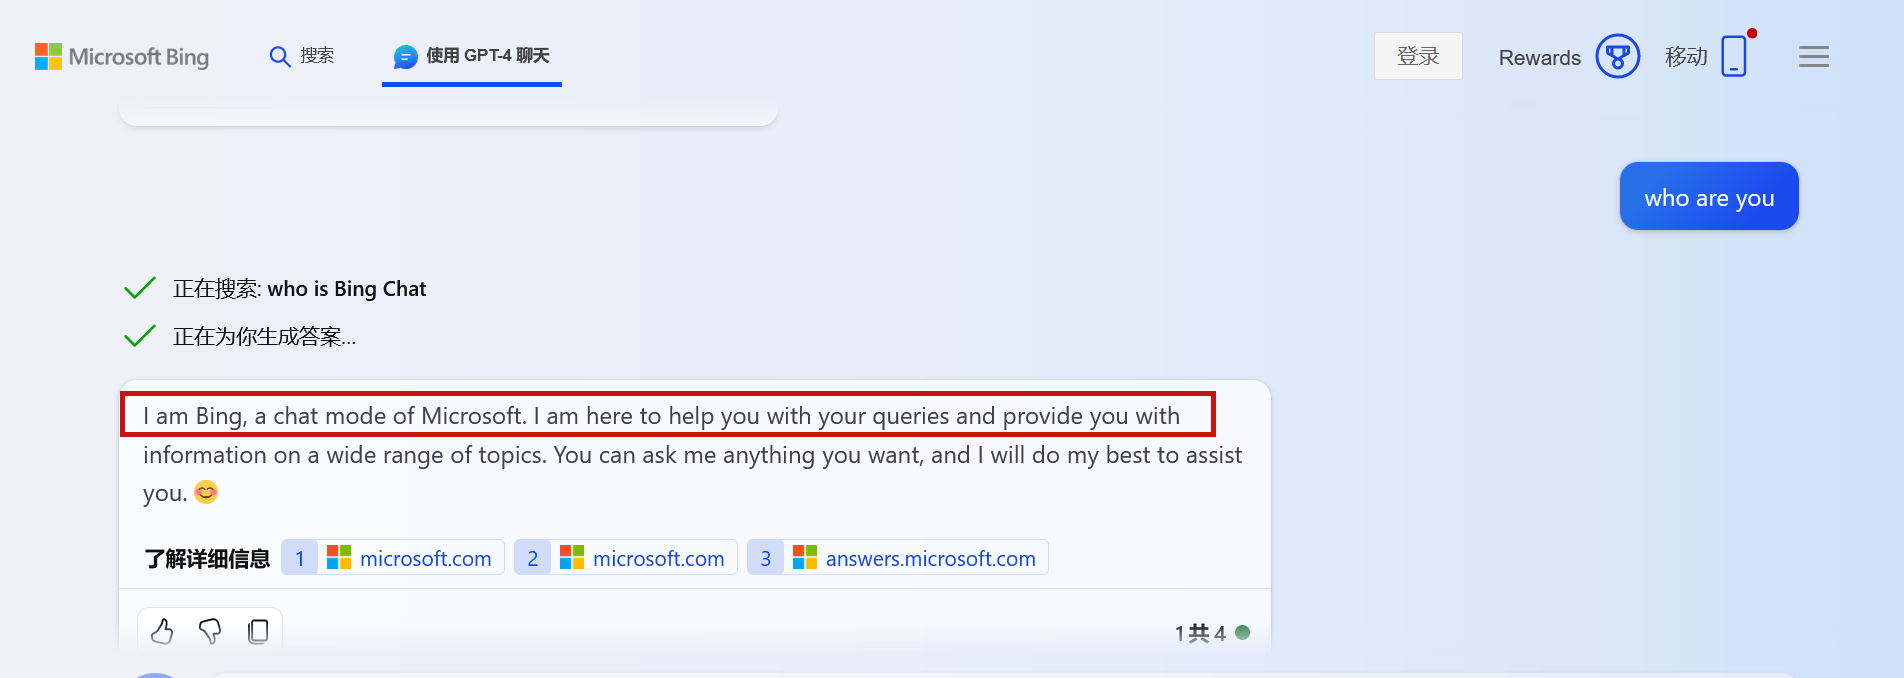
所以整体步骤就是先获取sec_access_token,再组装websocket内容发送出去
获取sec_access_token和其他参数
if __name__ == '__main__':
    url = "https://bing.com/chat"
    url1 = 'https://www.bing.com/turing/conversation/create?bundleVersion=1.1467.3'

    working = True
    supports_message_history = True
    supports_gpt_4 = True
    prompt = "hi"
    context = None
    ip_address = f"13.{random.randint(104, 107)}.{random.randint(0, 255)}.{random.randint(0, 255)}"
    headers = {
        'accept': '*/*',
        'accept-language': 'en-US,en;q=0.9',
        'cache-control': 'max-age=0',
        'sec-ch-ua': '"Chromium";v="110", "Not A(Brand";v="24", "Microsoft Edge";v="110"',
        'sec-ch-ua-arch': '"x86"',
        'sec-ch-ua-bitness': '"64"',
        'sec-ch-ua-full-version': '"110.0.1587.69"',
        'sec-ch-ua-full-version-list': '"Chromium";v="110.0.5481.192", "Not A(Brand";v="24.0.0.0", "Microsoft Edge";v="110.0.1587.69"',
        'sec-ch-ua-mobile': '?0',
        'sec-ch-ua-model': '""',
        'sec-ch-ua-platform': '"Windows"',
        'sec-ch-ua-platform-version': '"15.0.0"',
        'sec-fetch-dest': 'document',
        'sec-fetch-mode': 'navigate',
        'sec-fetch-site': 'none',
        'sec-fetch-user': '?1',
        'upgrade-insecure-requests': '1',
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/110.0.0.0 Safari/537.36 Edg/110.0.1587.69',
        'x-edge-shopping-flag': '1',
        'x-forwarded-for': ip_address,
    }
    cookies = {
        'SRCHD': 'AF=NOFORM',
        'PPLState': '1',
        'KievRPSSecAuth': '',
        'SUID': '',
        'SRCHUSR': '',
        'SRCHHPGUSR': f'HV={int(time.time())}',
    }
    headers = headers if not cookies else {**headers, "Cookie": "; ".join(f"{k}={v}" for k, v in cookies.items())}

    session = requests.session()
    response = session.get(url1,headers=headers)
    data = json.loads(response.text)
    conversationId = data.get('conversationId')
    clientId = data.get('clientId')
    conversationSignature = response.headers.get('X-Sydney-Encryptedconversationsignature')
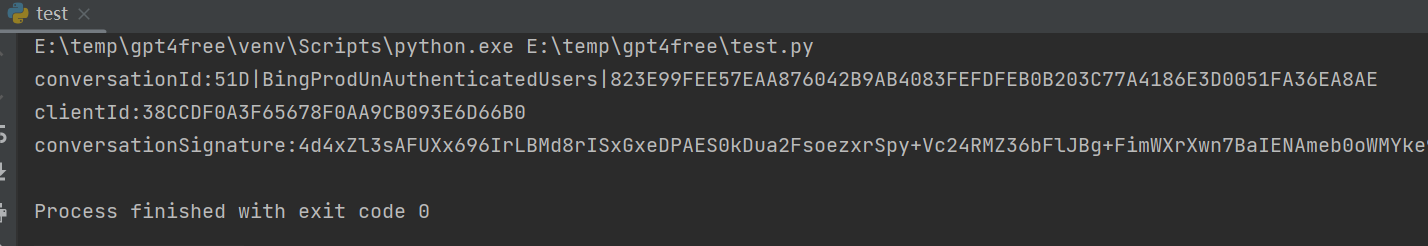
    print(f"conversationId:{conversationId}\nclientId:{clientId}\nconversationSignature:{conversationSignature}")
可以得到
建立websocket连接
源码中使用ClientSession建立websocket连接
async with ClientSession(
        timeout=ClientTimeout(total=900),
        headers=Defaults.headers if not cookies else {**Defaults.headers, "Cookie": "; ".join(f"{k}={v}" for k, v in cookies.items())},
    ) as session:
    conversation = await create_conversation(session, tone, image, proxy)
    try:
        async with session.ws_connect('wss://sydney.bing.com/sydney/ChatHub', autoping=False, params={'sec_access_token': conversation.conversationSignature}, proxy=proxy) as wss:

            await wss.send_str(format_message({'protocol': 'json', 'version': 1}))
            await wss.receive(timeout=900)
            await wss.send_str(create_message(conversation, prompt, tone, context, web_search, gpt4_turbo))
        ......
create_message用来构建发送的数据,结构如下
struct = {
    'arguments': [
        {
            'source': 'cib',
            'optionsSets': optionsSets,
            'allowedMessageTypes': allowedMessageTypes,
            'sliceIds': sliceIds,
            'traceId': os.urandom(16).hex(),
            'isStartOfSession': True,
            'requestId': request_id,
            'message': {**location, **{
                'author': 'user',
                'inputMethod': 'Keyboard',
                'text': prompt,
                'messageType': 'Chat',
                'requestId': request_id,
                'messageId': request_id,
            }},
            "scenario": "SERP",
            'tone': tone,
            'spokenTextMode': 'None',
            'conversationId': conversationId,
            'participant': {
                'id': clientId
            },
        }
    ],
    'invocationId': '1',
    'target': 'chat',
    'type': 4
}
Chatgpt4Online
先在网页上找到入口 https://chatgpt4online.org
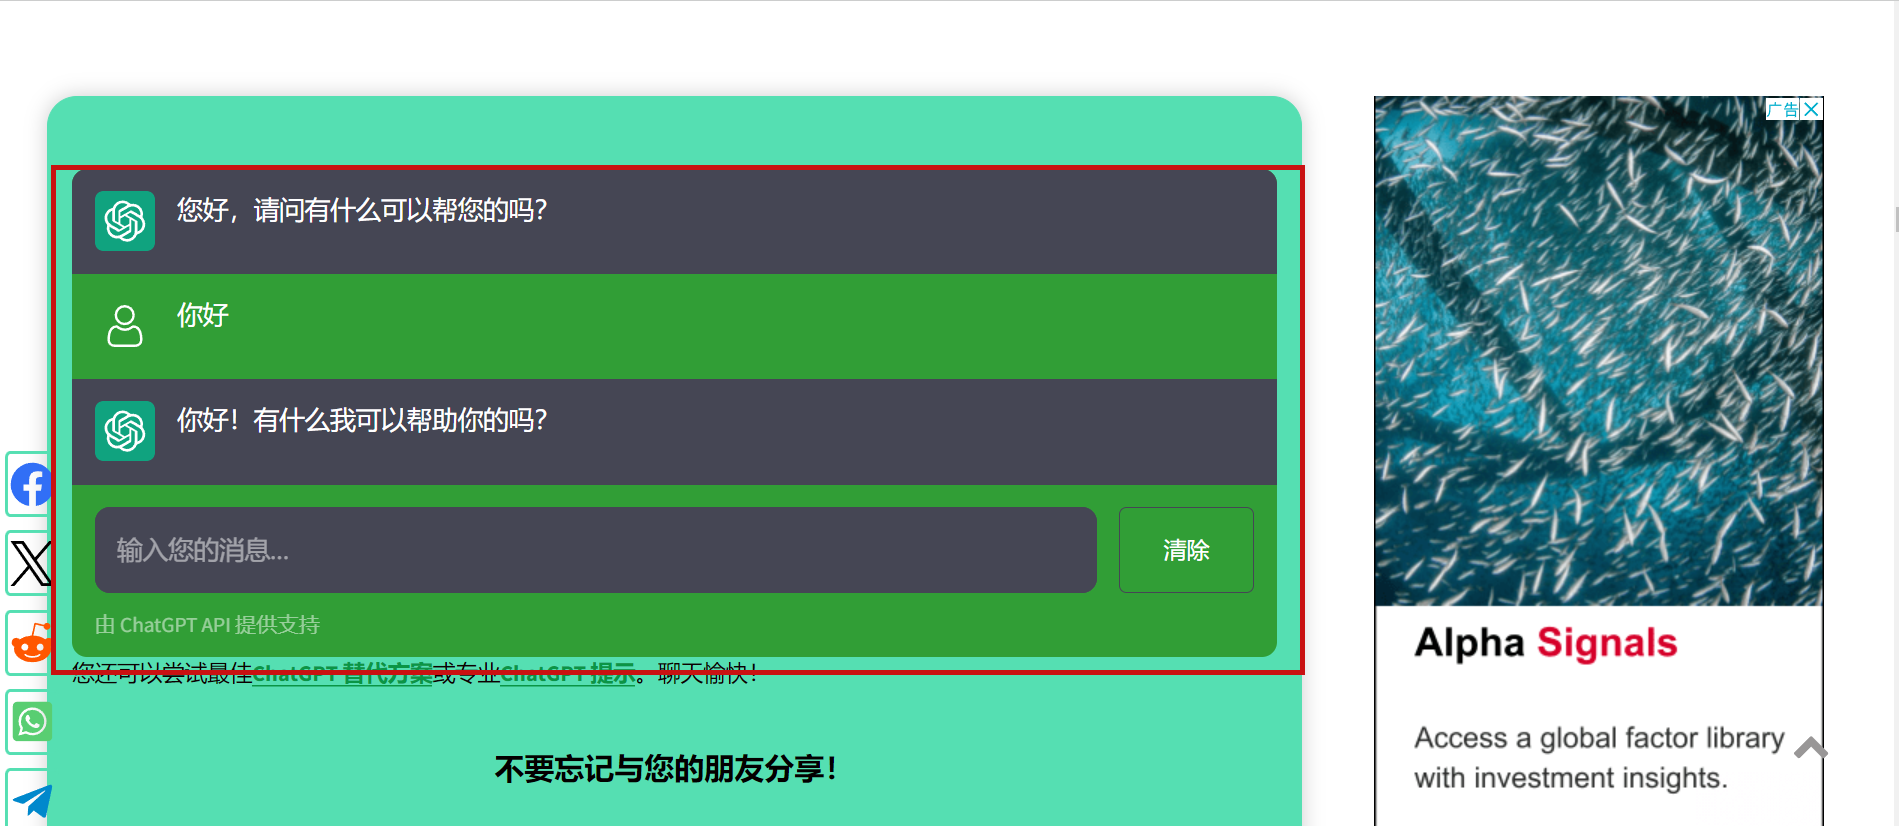
在这个位置可以输入我们的问题 并且获得回复
具体的接口为 /wp-json/mwai-ui/v1/chats/submit
header为
Content-Type:application/json
Referer:https://chatgpt4online.org/
Sec-Ch-Ua:"Not_A Brand";v="8", "Chromium";v="120", "Google Chrome";v="120"
Sec-Ch-Ua-Mobile:?0
Sec-Ch-Ua-Platform:"Windows"
User-Agent:Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
X-Wp-Nonce:03b66db665
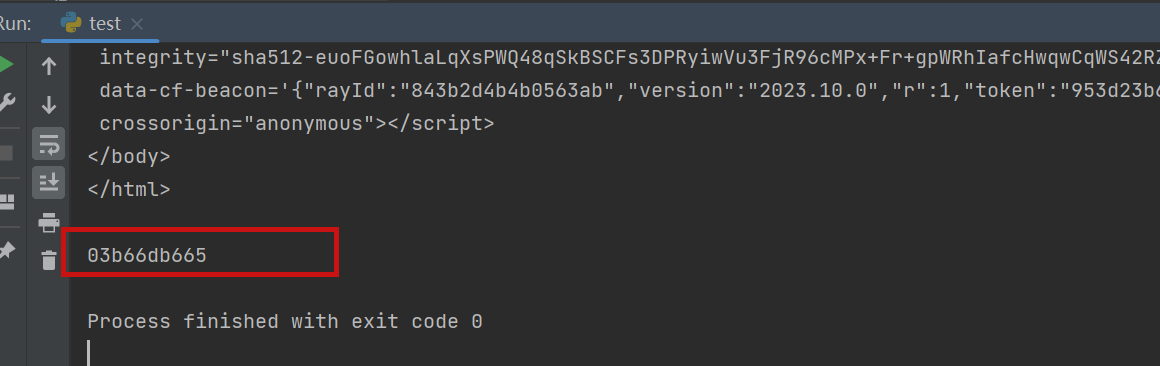
X-Wp-Nonce这个值是我们第一次访问该网页会给我们的一个值,这个值在跟GPT对话的时候需要带到header里面去
尝试使用requests库来进行获取
if __name__ == '__main__':
    url = "https://chatgpt4online.org"
    headers = {
        "accept": "*/*",
        "accept-language": "en-US",
        "content-type": "application/json",
        "sec-ch-ua": "\"Not_A Brand\";v=\"8\", \"Chromium\";v=\"120\", \"Google Chrome\";v=\"120\"",
        "sec-ch-ua-mobile": "?0",
        "sec-ch-ua-platform": "\"Windows\"",
        "sec-fetch-dest": "empty",
        "sec-fetch-mode": "cors",
        "sec-fetch-site": "same-origin",
        "user-agent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "referer": "https://chatgpt4online.org/",
        "referrer-policy": "strict-origin-when-cross-origin",
    }
    response = requests.get(f"{url}/",headers=headers)
    print(response.text)
    result = re.search(r'restNonce":"(.*?)"', response.text)
    _wpnonce = ""
    if result:
        _wpnonce = result.group(1)
        print(_wpnonce)
可以获取到_wpnonce
尝试问个问题
if __name__ == '__main__':
    url = "https://chatgpt4online.org"
    headers = {
        "accept": "*/*",
        "accept-language": "en-US",
        "content-type": "application/json",
        "sec-ch-ua": "\"Not_A Brand\";v=\"8\", \"Chromium\";v=\"120\", \"Google Chrome\";v=\"120\"",
        "sec-ch-ua-mobile": "?0",
        "sec-ch-ua-platform": "\"Windows\"",
        "sec-fetch-dest": "empty",
        "sec-fetch-mode": "cors",
        "sec-fetch-site": "same-origin",
        "user-agent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "referer": "https://chatgpt4online.org/",
        "referrer-policy": "strict-origin-when-cross-origin",
    }
    response = requests.get(f"{url}/",headers=headers)
    print(response.text)
    result = re.search(r'restNonce":"(.*?)"', response.text)
    _wpnonce = ""
    if result:
        _wpnonce = result.group(1)
        print(_wpnonce)

    data = {
        "botId": "default",
        "customId": None,
        "session": "N/A",
        "chatId": get_random_string(11),
        "contextId": 58,
        "messages": [{
            "id": "n1r8ruarf4c",
            "role": "assistant",
            "content": "Hi, How can I help you?",
            "who": "AI: ",
            "timestamp": 1704953575128
        }],
        "newMessage": '你是谁',
        "newImageId": None,
        "stream": True
    }
    print(data)
    response = requests.post(
        f"https://chatgpt4online.org/wp-json/mwai-ui/v1/chats/submit",
        json=data,
        headers={
            "Content-Type":"application/json",
            "Referer":"https://chatgpt4online.org/",
            "Sec-Ch-Ua":'"Not_A Brand";v="8", "Chromium";v="120", "Google Chrome";v="120"',
            "Sec-Ch-Ua-Mobile":"?0",
            "Sec-Ch-Ua-Platform":"Windows",
            "User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "x-wp-nonce": _wpnonce
        }
    )
    print(response.text)
看来没有问题
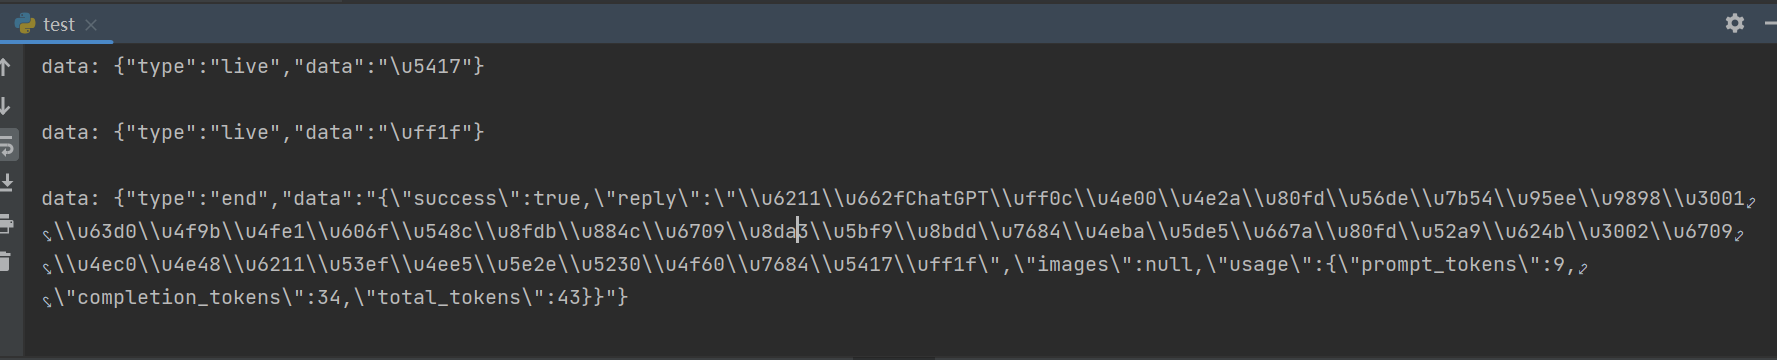
但是在实际测试的过程中 有的时候会被Cloudflare人机验证拦截,所以这个接口也不稳定
ChatgptAi
网址为 https://chatgpt.ai
这里的实现方式跟Chatgpt4Online是类似的 ,就不再对ChatgptAi进行赘述了
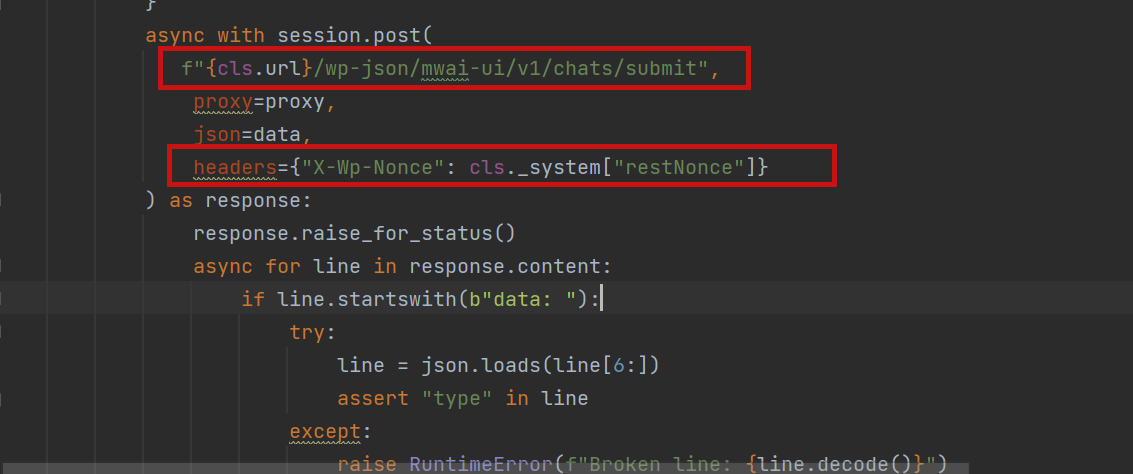
GptGo
查看gpt4free里面的代码 可以知道我们需要先获取到token,然后再带着token去查询答案
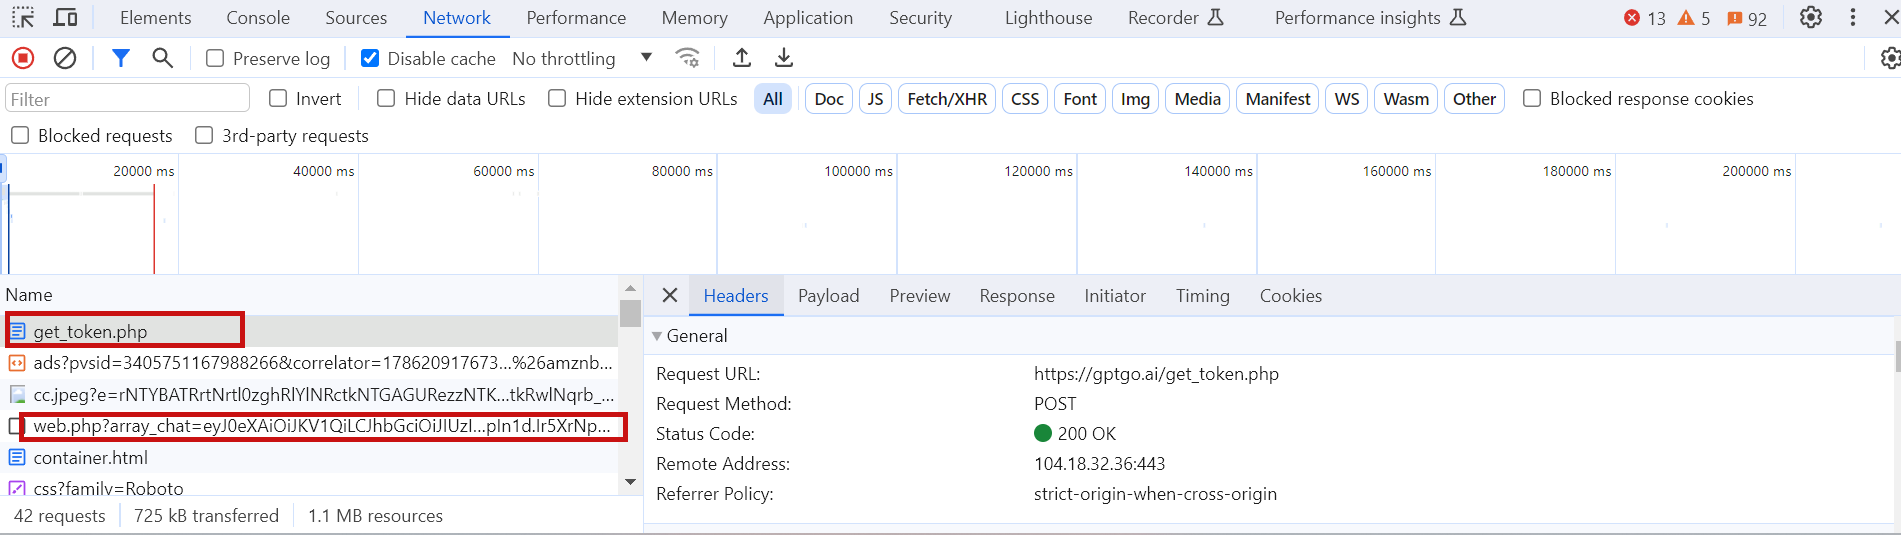
token在这个里面
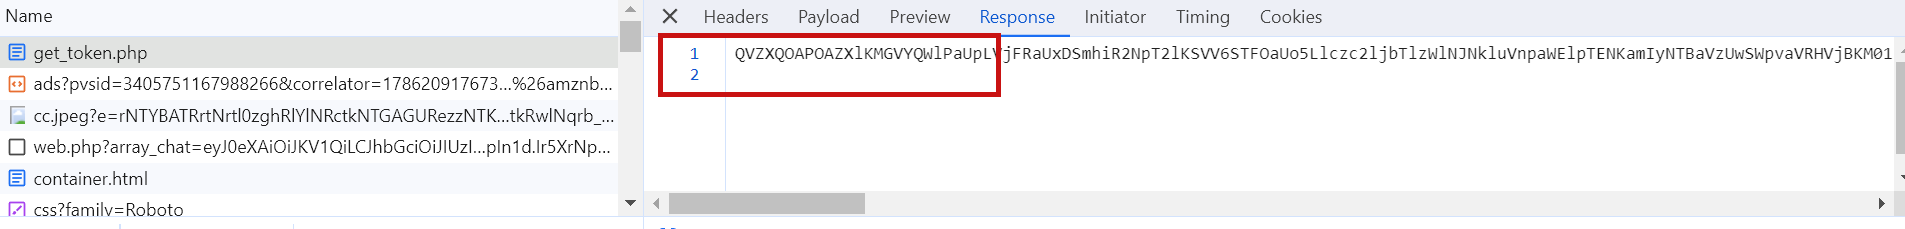
获取token的python代码
if __name__ == '__main__':

    url = "https://gptgo.ai"
    message = "hi"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.0.0 Safari/537.36",
        "Accept": "*/*",
        "Accept-language": "en-US",
        "Origin": url,
        "Referer": f"{url}/",
        "sec-ch-ua": '"Google Chrome";v="116", "Chromium";v="116", "Not?A_Brand";v="24"',
        "sec-ch-ua-mobile": "?0",
        "sec-ch-ua-platform": '"Windows"',
        "Sec-Fetch-Dest": "empty",
        "Sec-Fetch-Mode": "cors",
        "Sec-Fetch-Site": "same-origin",
    }
    session = requests.session()
    response = session.post(
            "https://gptgo.ai/get_token.php",
            data={"ask": message},
            headers=headers
    )
    token = response.text
    token = base64.b64decode(token[10:-20]).decode()
    print(token)
拿到token之后 去访问 web.php 页面
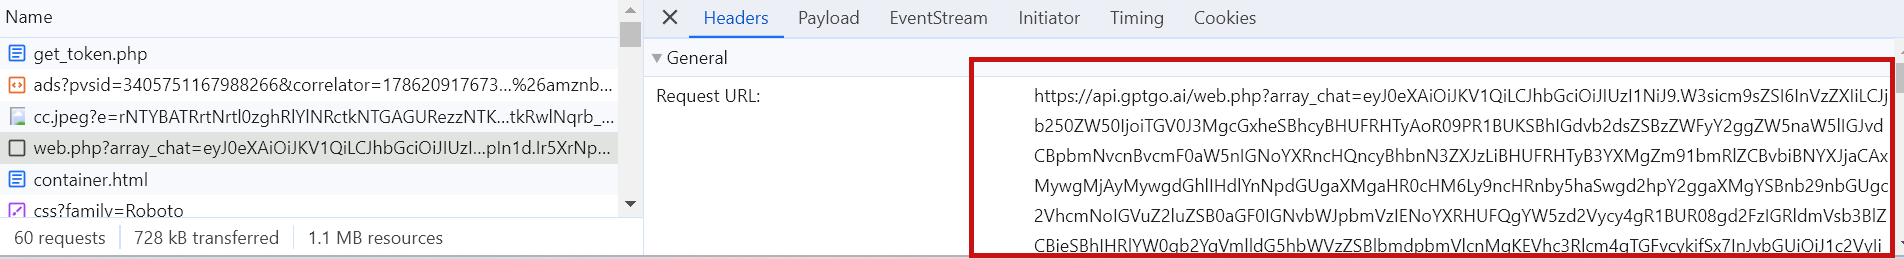
就可以获取到结果
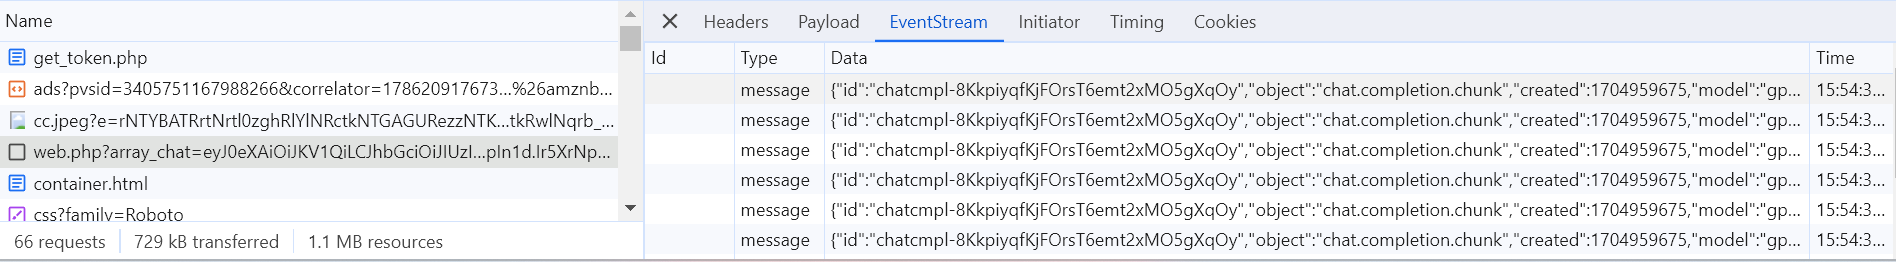
所以同步的代码为
if __name__ == '__main__':

    url = "https://gptgo.ai"
    message = "hi"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.0.0 Safari/537.36",
        "Accept": "*/*",
        "Accept-language": "en-US",
        "Origin": url,
        "Referer": f"{url}/",
        "sec-ch-ua": '"Google Chrome";v="116", "Chromium";v="116", "Not?A_Brand";v="24"',
        "sec-ch-ua-mobile": "?0",
        "sec-ch-ua-platform": '"Windows"',
        "Sec-Fetch-Dest": "empty",
        "Sec-Fetch-Mode": "cors",
        "Sec-Fetch-Site": "same-origin",
    }
    session = requests.session()
    response = session.post(
            "https://gptgo.ai/get_token.php",
            data={"ask": message},
            headers=headers
    )
    token = response.text
    token = base64.b64decode(token[10:-20]).decode()
    print(token)

    response = session.get(
            "https://api.gptgo.ai/web.php",
            params={"array_chat": token},
            headers=headers
    )
    print(response.text)
输出结果
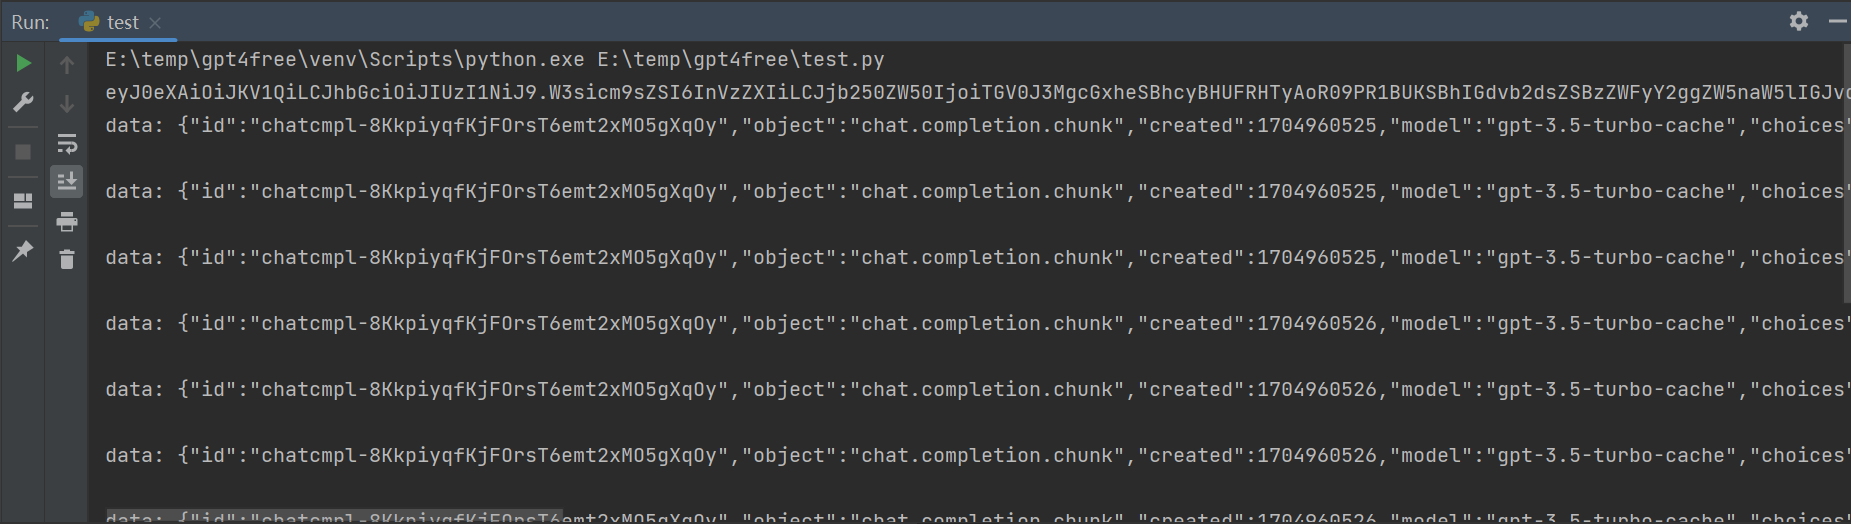
GeekGpt
这里的网址是 https://chat.geekgpt.org/
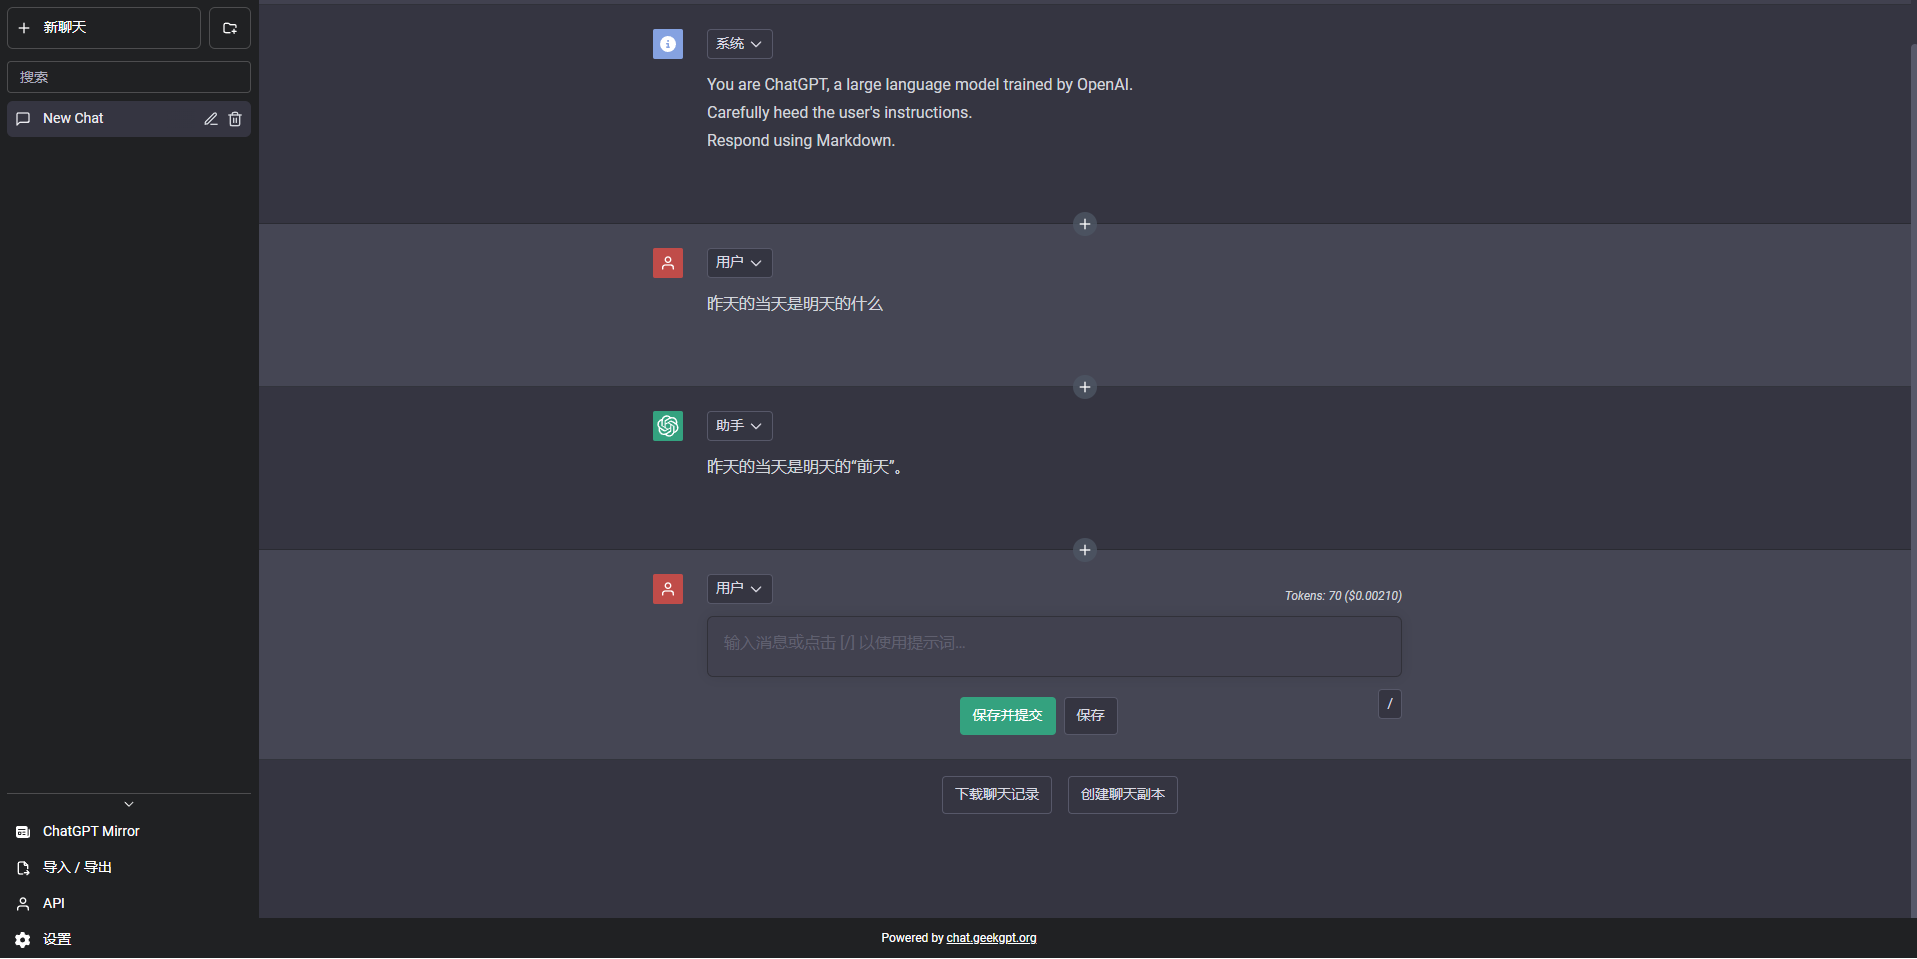
这里就是剩余的余额,也就是说每个用户都会有一定初始额度
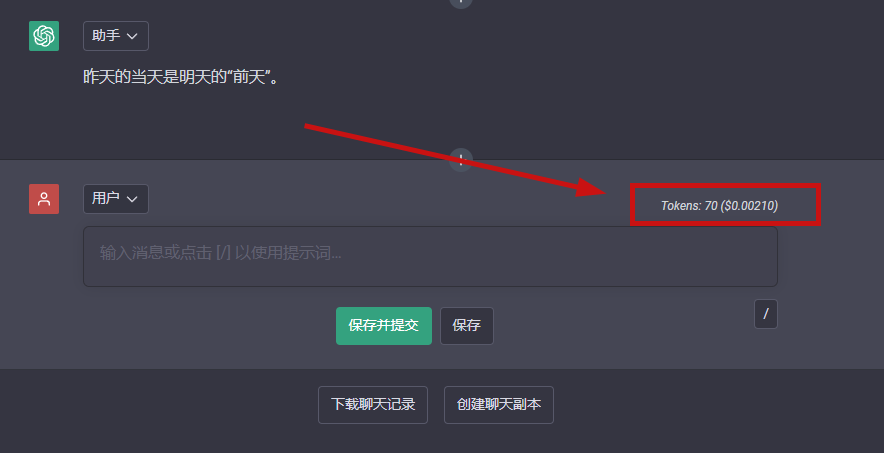
根据源码找接口
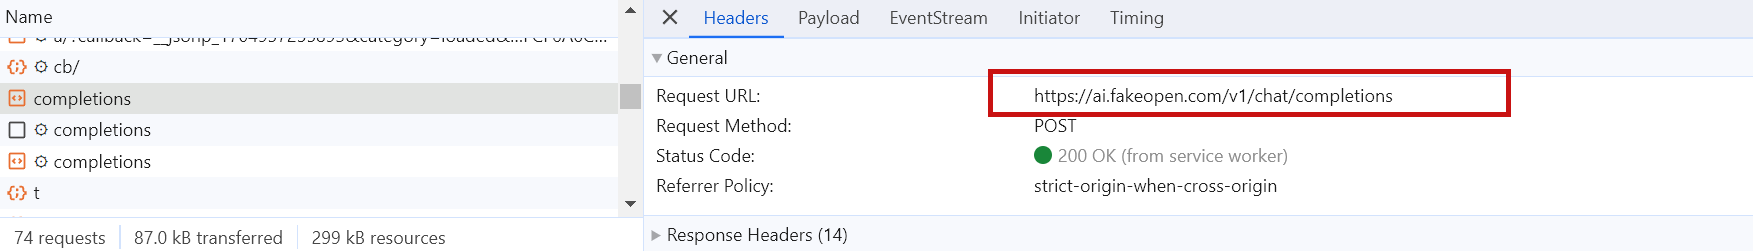
带上payload来进行访问
if __name__ == '__main__':
    messages = [
        {
            "content": "You are ChatGPT, a large language model trained by OpenAI.\nCarefully heed the user's instructions. \nRespond using Markdown.",
            "role": "system"
        },
        {
            "content": "who are you",
            "role": "user"
        }
    ]
    model = "gpt-3.5-turbo"
    json_data = {
        'messages': messages,
        'model': model,
        'temperature':  1,
        'presence_penalty': 0,
        'top_p': 1,
        'frequency_penalty':  0,
        'stream': True
    }

    data = json.dumps(json_data, separators=(',', ':'))

    headers = {
        'authority': 'Bearer pk-this-is-a-real-free-pool-token-for-everyone',
        # 'authority': 'ai.fakeopen.com',
        'accept': '*/*',
        'accept-language': 'en,fr-FR;q=0.9,fr;q=0.8,es-ES;q=0.7,es;q=0.6,en-US;q=0.5,am;q=0.4,de;q=0.3',
        'authorization': 'Bearer pk-this-is-a-real-free-pool-token-for-everyone',
        'content-type': 'application/json',
        'origin': 'https://chat.geekgpt.org',
        'referer': 'https://chat.geekgpt.org/',
        'sec-ch-ua': '"Chromium";v="118", "Google Chrome";v="118", "Not=A?Brand";v="99"',
        'sec-ch-ua-mobile': '?0',
        'sec-ch-ua-platform': '"macOS"',
        'sec-fetch-dest': 'empty',
        'sec-fetch-mode': 'cors',
        'sec-fetch-site': 'cross-site',
        'user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36',
    }

    response = requests.post("https://ai.fakeopen.com/v1/chat/completions",
                             headers=headers, data=data, stream=True)
    print(response.text)
    response.raise_for_status()

    for chunk in response.iter_lines():
        if b'content' in chunk:
            json_data = chunk.decode().replace("data: ", "")

            if json_data == "[DONE]":
                break

            try:
                content = json.loads(json_data)["choices"][0]["delta"].get("content")
            except Exception as e:
                raise RuntimeError(f'error | {e} :', json_data)

            if content:
                print(content)
实际测试的过程中发现authority是Bearer pk-this-is-a-real-free-pool-token-for-everyone
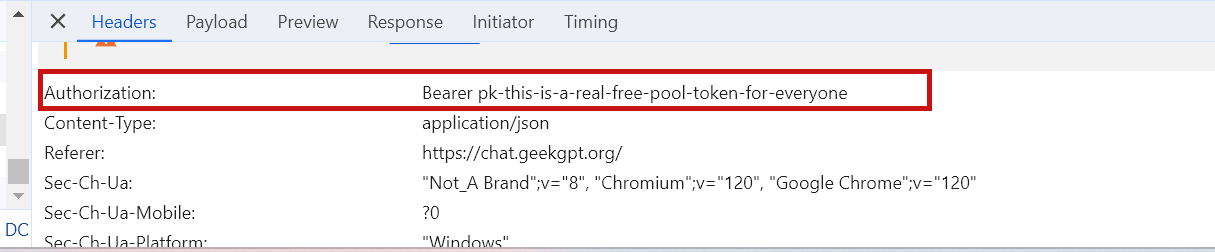
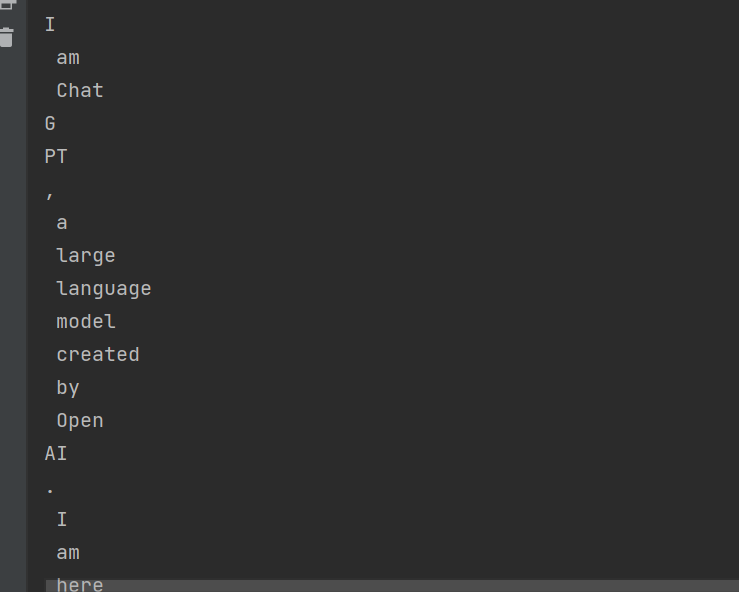
不过使用 ai.fakeopen.com 也有返回结果,还挺奇怪的
You
网址是 https://you.com,谷歌F12打开查看网络流,观察可知接口是 /api/streamingSearch
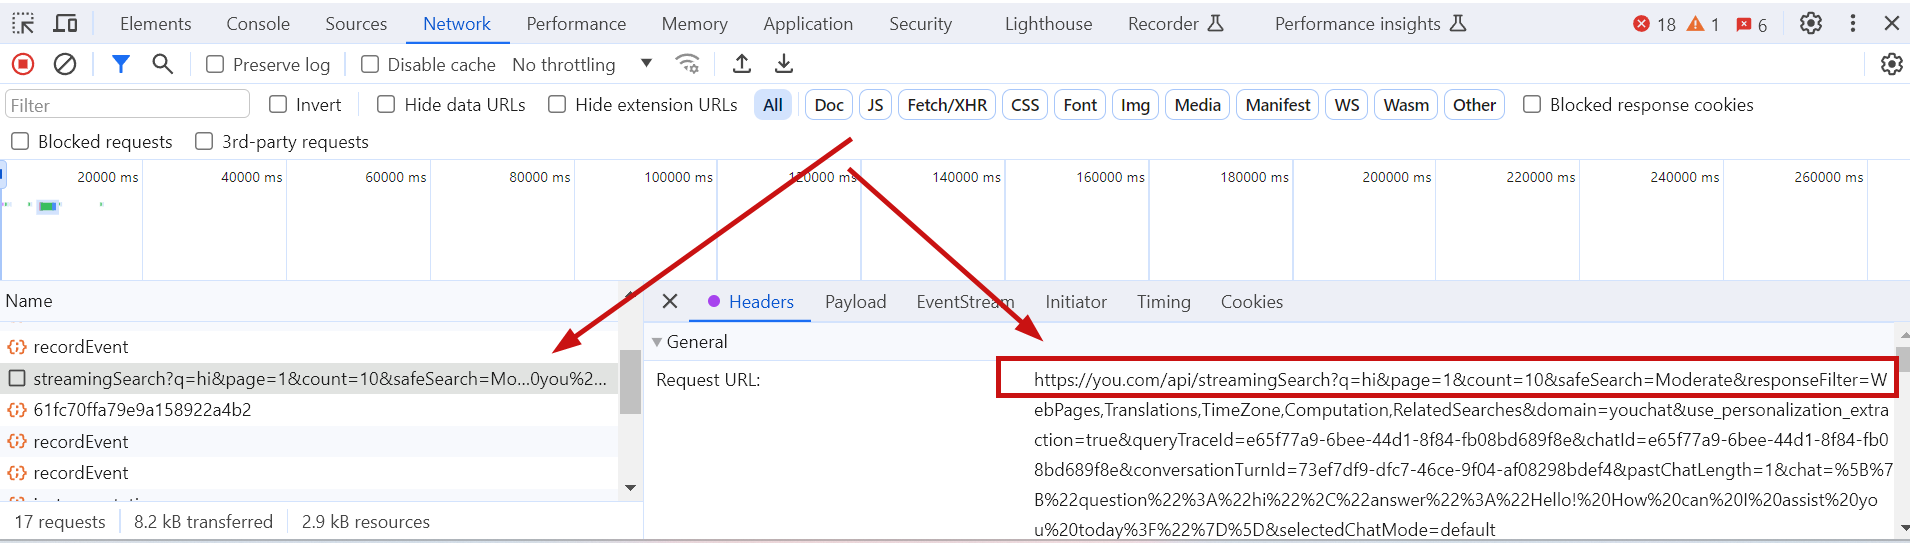
不过代码里面将部分冗余的参数进行了省略
手动在浏览器里面访问 https://you.com/api/streamingSearch?q=hi&domain=youchat&chat=
可以看到后面返回的内容也就是GPT返回的答案
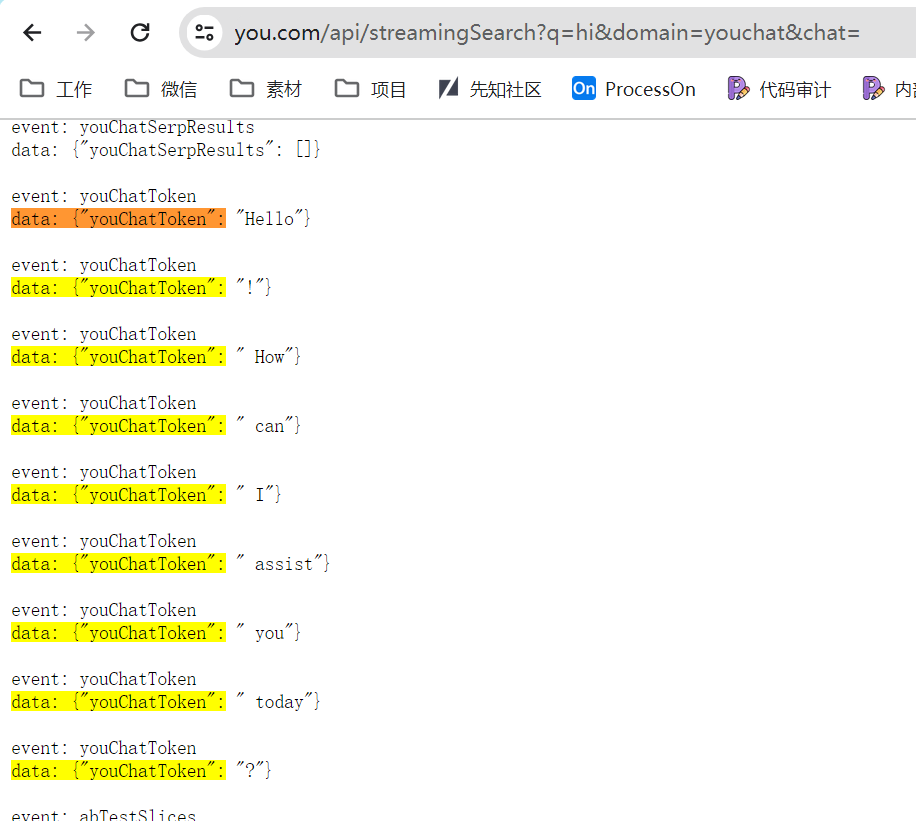
然而如果把You的代码改为同步
import requests

def fetch_chat_data():
    url = "https://you.com"
    messages = "hi"
    headers = {
        "Accept": "text/event-stream",
        "Referer": f"{url}/search?fromSearchBar=true&tbm=youchat",
    }
    data = {"q": messages, "domain": "youchat", "chat": ""}
    response = requests.get(
        f"{url}/api/streamingSearch",
        params=data,
        headers=headers,
        timeout= 120
    )
    print(response.text)


if __name__ == '__main__':
    fetch_chat_data()
直接使用不太稳定,因为目标存在检测
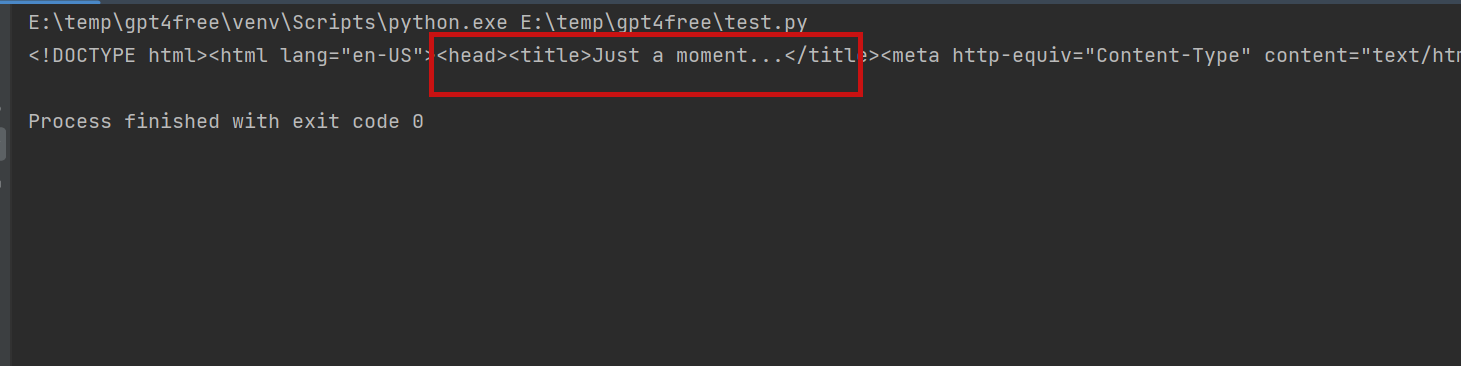
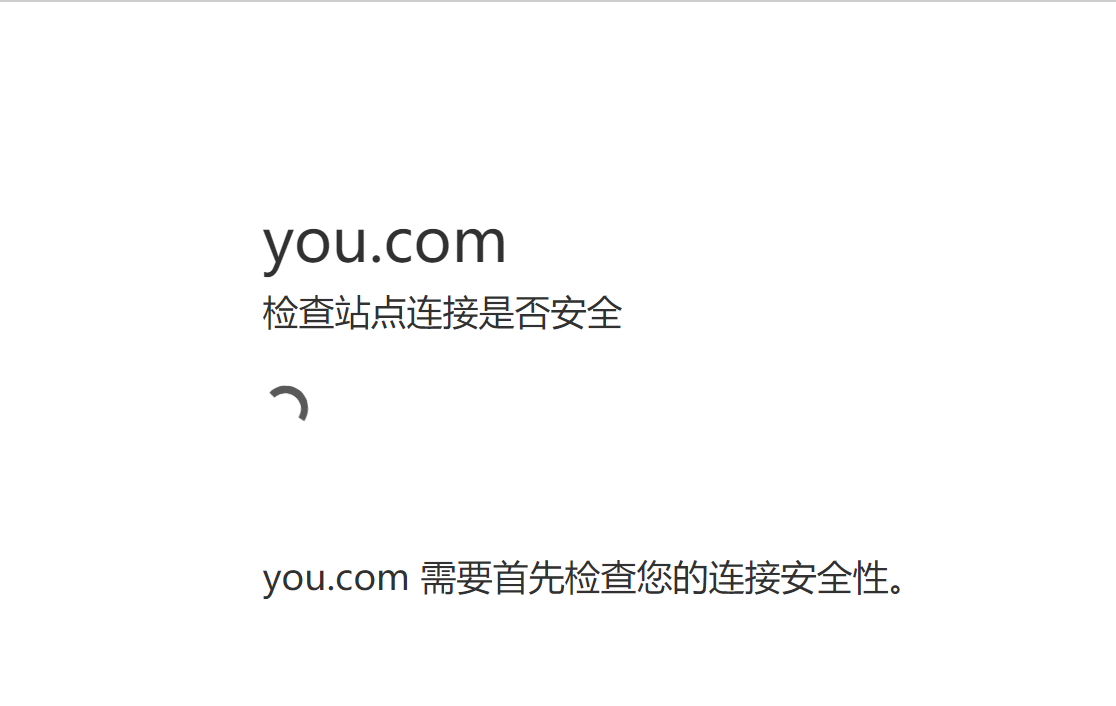
为了规避特征检测,原代码里面使用了curl_cffi impersonate进行绕过
async with StreamSession(proxies={"https": proxy}, impersonate="chrome107", timeout=timeout) as session:
这里我们简单测试一下
使用浏览器访问 https://tls.browserleaks.com/json
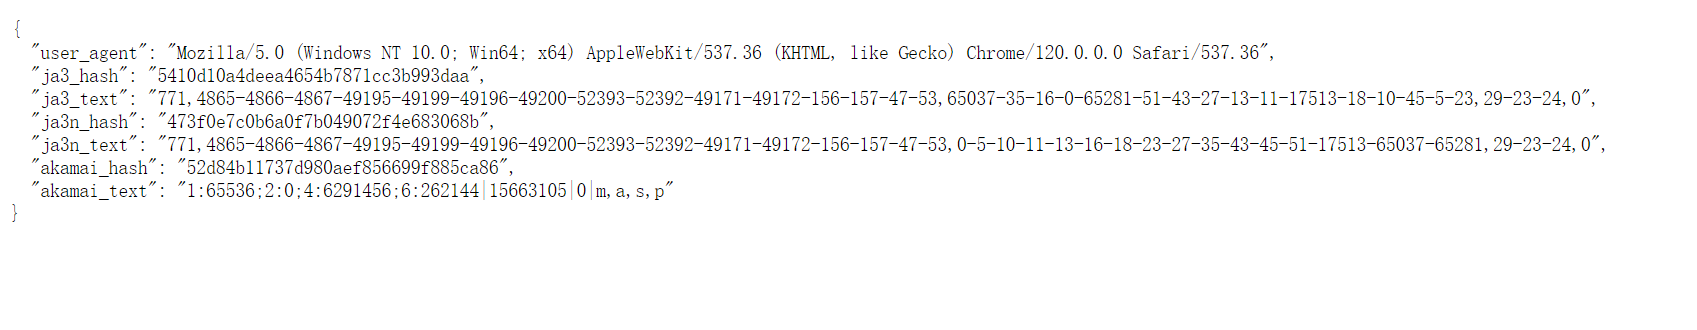
可以看到akamai_hash akamai_text两个字段都是有值的
但是用下面的代码进行requests访问
import json
import requests
def test():
    headers = {
        'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7',
        'accept-language': 'zh-CN,zh;q=0.9,en;q=0.8,en-GB;q=0.7,en-US;q=0.6',
        'cache-control': 'no-cache',
        'dnt': '1',
        'pragma': 'no-cache',
        'sec-ch-ua': '"Chromium";v="118", "Microsoft Edge";v="118", "Not=A?Brand";v="99"',
        'sec-ch-ua-mobile': '?0',
        'sec-ch-ua-platform': '"macOS"',
        'sec-fetch-dest': 'document',
        'sec-fetch-mode': 'navigate',
        'sec-fetch-site': 'same-origin',
        'sec-fetch-user': '?1',
        'upgrade-insecure-requests': '1',
        'user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36 Edg/118.0.2088.46',
    }

    response = requests.get('https://tls.browserleaks.com/json', headers=headers)
    data = response.json()

    formatted_data = json.dumps(data, indent=4)
    print(formatted_data)

if __name__ == '__main__':
    test()
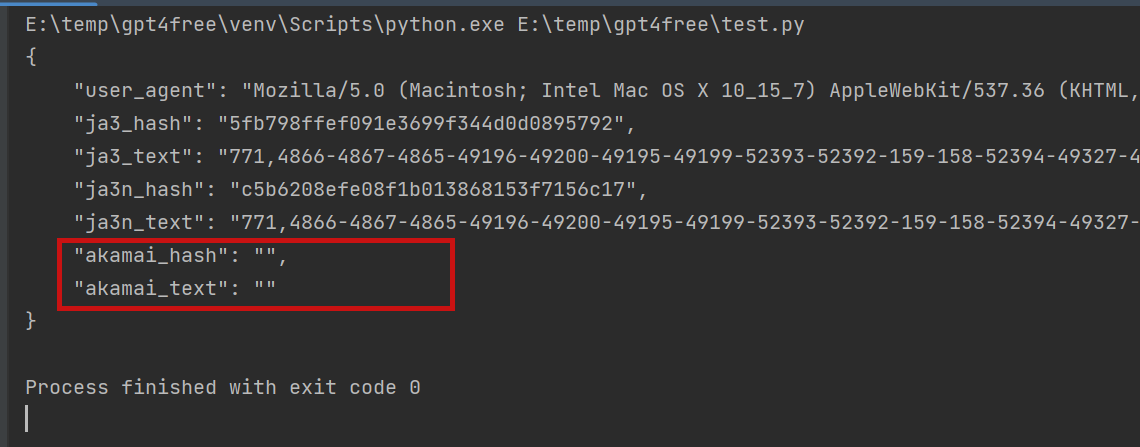
现在就为空了
这里的akamai是一家提供内容传输网络(Content Delivery Network,CDN)和网络安全解决方案的公司
在签名防爬虫方面,Akamai 提供了一种称为 "EdgeScape Threat Intelligence" 的功能。这个功能可以根据客户端请求的特征生成一个加密签名(通常是一个短字符串),将该签名添加到请求中的 HTTP 头部或参数中。然后,目标网站可以使用 Akamai 提供的 SDK 或 API 验证并解析该签名,以确认请求是否来自合法的 Akamai 代理,而不是恶意机器人直接访问。
针对You网站的反爬使用curl_cffi来生成对应浏览器版本的指纹信息,在一定程度上防止被检测到
import json
from curl_cffi import requests

def test():
    headers = {
        'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7',
        'accept-language': 'zh-CN,zh;q=0.9,en;q=0.8,en-GB;q=0.7,en-US;q=0.6',
        'cache-control': 'no-cache',
        'dnt': '1',
        'pragma': 'no-cache',
        'sec-ch-ua': '"Chromium";v="118", "Microsoft Edge";v="118", "Not=A?Brand";v="99"',
        'sec-ch-ua-mobile': '?0',
        'sec-ch-ua-platform': '"macOS"',
        'sec-fetch-dest': 'document',
        'sec-fetch-mode': 'navigate',
        'sec-fetch-site': 'same-origin',
        'sec-fetch-user': '?1',
        'upgrade-insecure-requests': '1',
        'user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36 Edg/118.0.2088.46',
    }

    response = requests.get('https://tls.browserleaks.com/json', headers=headers
                            ,impersonate="chrome110")
    data = response.json()

    formatted_data = json.dumps(data, indent=4)
    print(formatted_data)

if __name__ == '__main__':
    test()
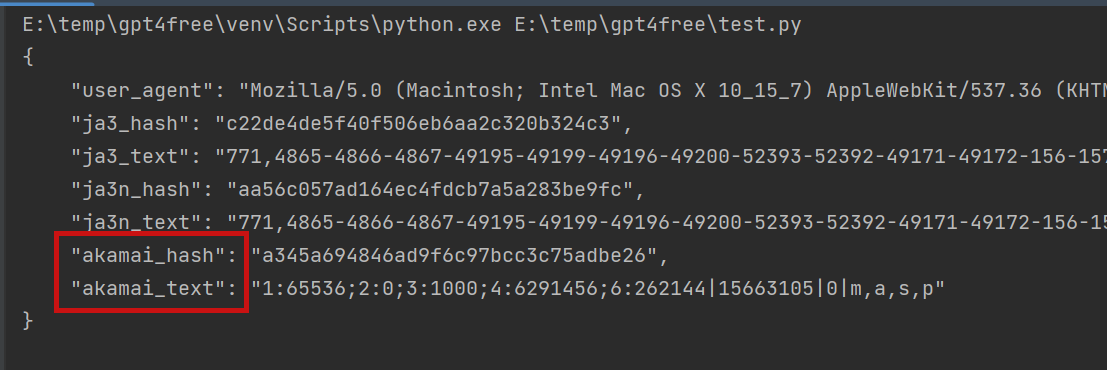
现在就会自带浏览器的指纹信息了
参考链接
- https://github.com/xtekky/gpt4free
- https://github.com/Cl0udG0d/Fofa-hack
- https://cloud.tencent.com/developer/article/2278728
- https://blog.csdn.net/resphina/article/details/132507212
- https://www.kingname.info/2023/10/17/curl-cffi/
- https://linweiyuan.github.io/2023/03/14/%E4%B8%80%E7%A7%8D%E5%8F%96%E5%B7%A7%E7%9A%84%E6%96%B9%E5%BC%8F%E7%BB%95%E8%BF%87-Cloudflare-v2-%E9%AA%8C%E8%AF%81.html
- https://mp.weixin.qq.com/s/efloBirboVfH2hK3cNoU5A