CVE-2020-4054:Ruby Sanitize < 5.2.1 可被绕过

CVE-2020-4054:Ruby Sanitize < 5.2.1 可被绕过 1. 译文声明 本文是翻译文章,原作者 Michał Bentkowski 原文地址:https://research.securitum.com/html-sanitization-bypass-in-ruby-sanitize-5-2-1/ 译文仅作参考,具体内容表达请见原文 2. 前言 于2020/06/
CVE-2020-4054:Ruby Sanitize < 5.2.1 可被绕过
1. 译文声明
本文是翻译文章,原作者 Michał Bentkowski
原文地址:https://research.securitum.com/html-sanitization-bypass-in-ruby-sanitize-5-2-1/
译文仅作参考,具体内容表达请见原文
2. 前言
于2020/06/16,Ruby Sanitize项目官方发布了编号为`CVE-2020-4054的漏洞公告,当Sanitize模块的过滤规则被配置成RELAXED时,利用该漏洞可以绕过该模块的安全过滤功能。具体配置信息可以查看lib/sanitize/config/relaxed.rb文件。
我曾在Securitum团队主导的渗透测试计划中发现了该漏洞,在这篇文章中,我将分享该漏洞的发现过程和触发方式。
3. HTML语法过滤基础思路
这部分将讲述恶意HTML文本的检测思路与过滤手法,有相关经验的大佬可以直接跳过。
Sanitize是一个用于检测HTML恶意语法并过滤的Ruby模块,其基于白名单的工作方式,提取到输入内容中的HTML标签后,分析并删除不在白名单内的标签,随后生成相对安全的HTML内容,用户可自定自己的白名单规则(例如,只允许<b>、<i>标签),不过该模块有一些默认的规则内容,接下来我会分析RELAXED过滤规则场景下的默认可信标签,列表如下:
<a> <abbr> <address <article> <aside> <bdi> <bdo> <blockquote> <body> <br> <caption> <cite>
<code> <col> <colgroup> <data> <dd> <del> <dfn> <div> <dl> <dt> <figcaption> <figure> <footer>
<h1> <h2> <h3> <h4> <h5> <h6> <head> <header> <hgroup> <hr> <html> <img> <ins> <kbd> <li> <main> <mark> <nav> <ol> <p> <pre <q> <rp> <rt> <ruby> <s> <samp> <section> <small> <span> <strike> <style> <sub> <summary> <sup> <table> <tbody> <td> <tfoot> <th> <thead> <time> <title> <tr> <ul> <var> <wbr>
HTML恶意检测的工作大致分为三步:
- 将HTML解析为DOM树
- 从DOM树中删除不可行的标签和属性
- 将新的DOM树序列化为HTML标签
举个例子,当输入内容如下时:首先会被解析为以下DOM树:ABC<script>alert(1)</script><img src=1 onerror=alert(2)>

其中script标签和onerror属性不在白名单规则内,随后将被删除。新的DOM树如下:

反序列化后如下:
ABC<img src="1">
理想状态下对输入内容进行过滤后其输出内容都是安全的。
4. style标签的解析与序列化
Sanitize模块的安全标签列表中包含<style>标签,可以从它入手,因为该标签的处理方式与其它不同。首先,HTML解析器不会解码<style>标签中的HTML实体。举个例子:
<div>I <3 XSS</div>
<style>I <3 XSS</style>
生成如下DOM树:

可以看到,<在<div>标签中已被HTML解码,但在<style>标签中没有。编码的大致过程为''<>等特殊字符被替换成&"<>。
然后,对于一些特定标签比如<style>标签,在反序列化生成新的HTML内容时没有进行HTML实体编码,举个例子:

反序列化生成的HTML内容为:
<div>I <3 XSS</div>
<style>I <3 XSS</style>
可以看到<字符在<div>标签内进行了HTML编码为<,但在<style>标签中没有。
该特性可被恶意利用,比如如下DOM树:

其由Sanitize反序列化生成HTML内容为:
<style></style><img src onerror=alert(1)>
这将产生XSS漏洞。
接下来的问题是:如何构造出一个恶意的DOM树?
5. Foreign content特性
HTML规范中有很多有趣的特性,当存在<svg>或者<math>标签时,解析规则会产生变化且上述中<style>标签的两个特性将不再受用,该特性就是:
<svg>/<math>标签中的内容会进行HTML实体解码。理想状态下在Sanitize场景下就会生成一个恶意的DOM树
举个例子:
<svg><style>I <3 XSS
对应的DOM树为:

最终输出为如下并产生XSS漏洞:
<svg><style>I <3 XSS</style></svg>
6. 绕过思路
回到主题,如何绕过Sanitize的过滤规则?
RELAXED配置场景下,<style>标签允许输入但是<svg>/<math>标签都不行,Sanitize使用的是Google Gumbo解析器,它支持HTML5中的新特性。Sanitize对CSS语法也进行了安全过滤,但是我发现! 使用/**/注释的方法可以进行有效的代码注入,举个例子:
<svg><style>/*</style><img src onerror=alert(1)*/
DOM树如下:
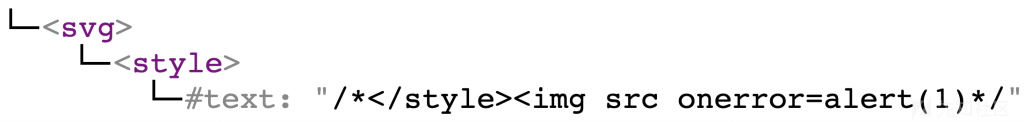
<svg>标签由于不在白名单中被删除了。但其内容仍然存在,因此,此时的DOM树如下:

此时已不再需要进行过滤了,因此反序列化生成的HTML代码为:
<style>/*</style><img src onerror=alert(1)>*/
好了,XSS已经giao出来了。
